RELIABILITY-AWARE · MULTIMODAL SENTIMENT
多模态情感预测
当文字、语音或视觉缺失一段,如何继续理解情感?EmoMosaic 将可靠性感知的 RM-Net 与 BERT LoRA 文本专家融合,在保留时序位置的同时预测情感极性与强度,并解释每种模态的作用。
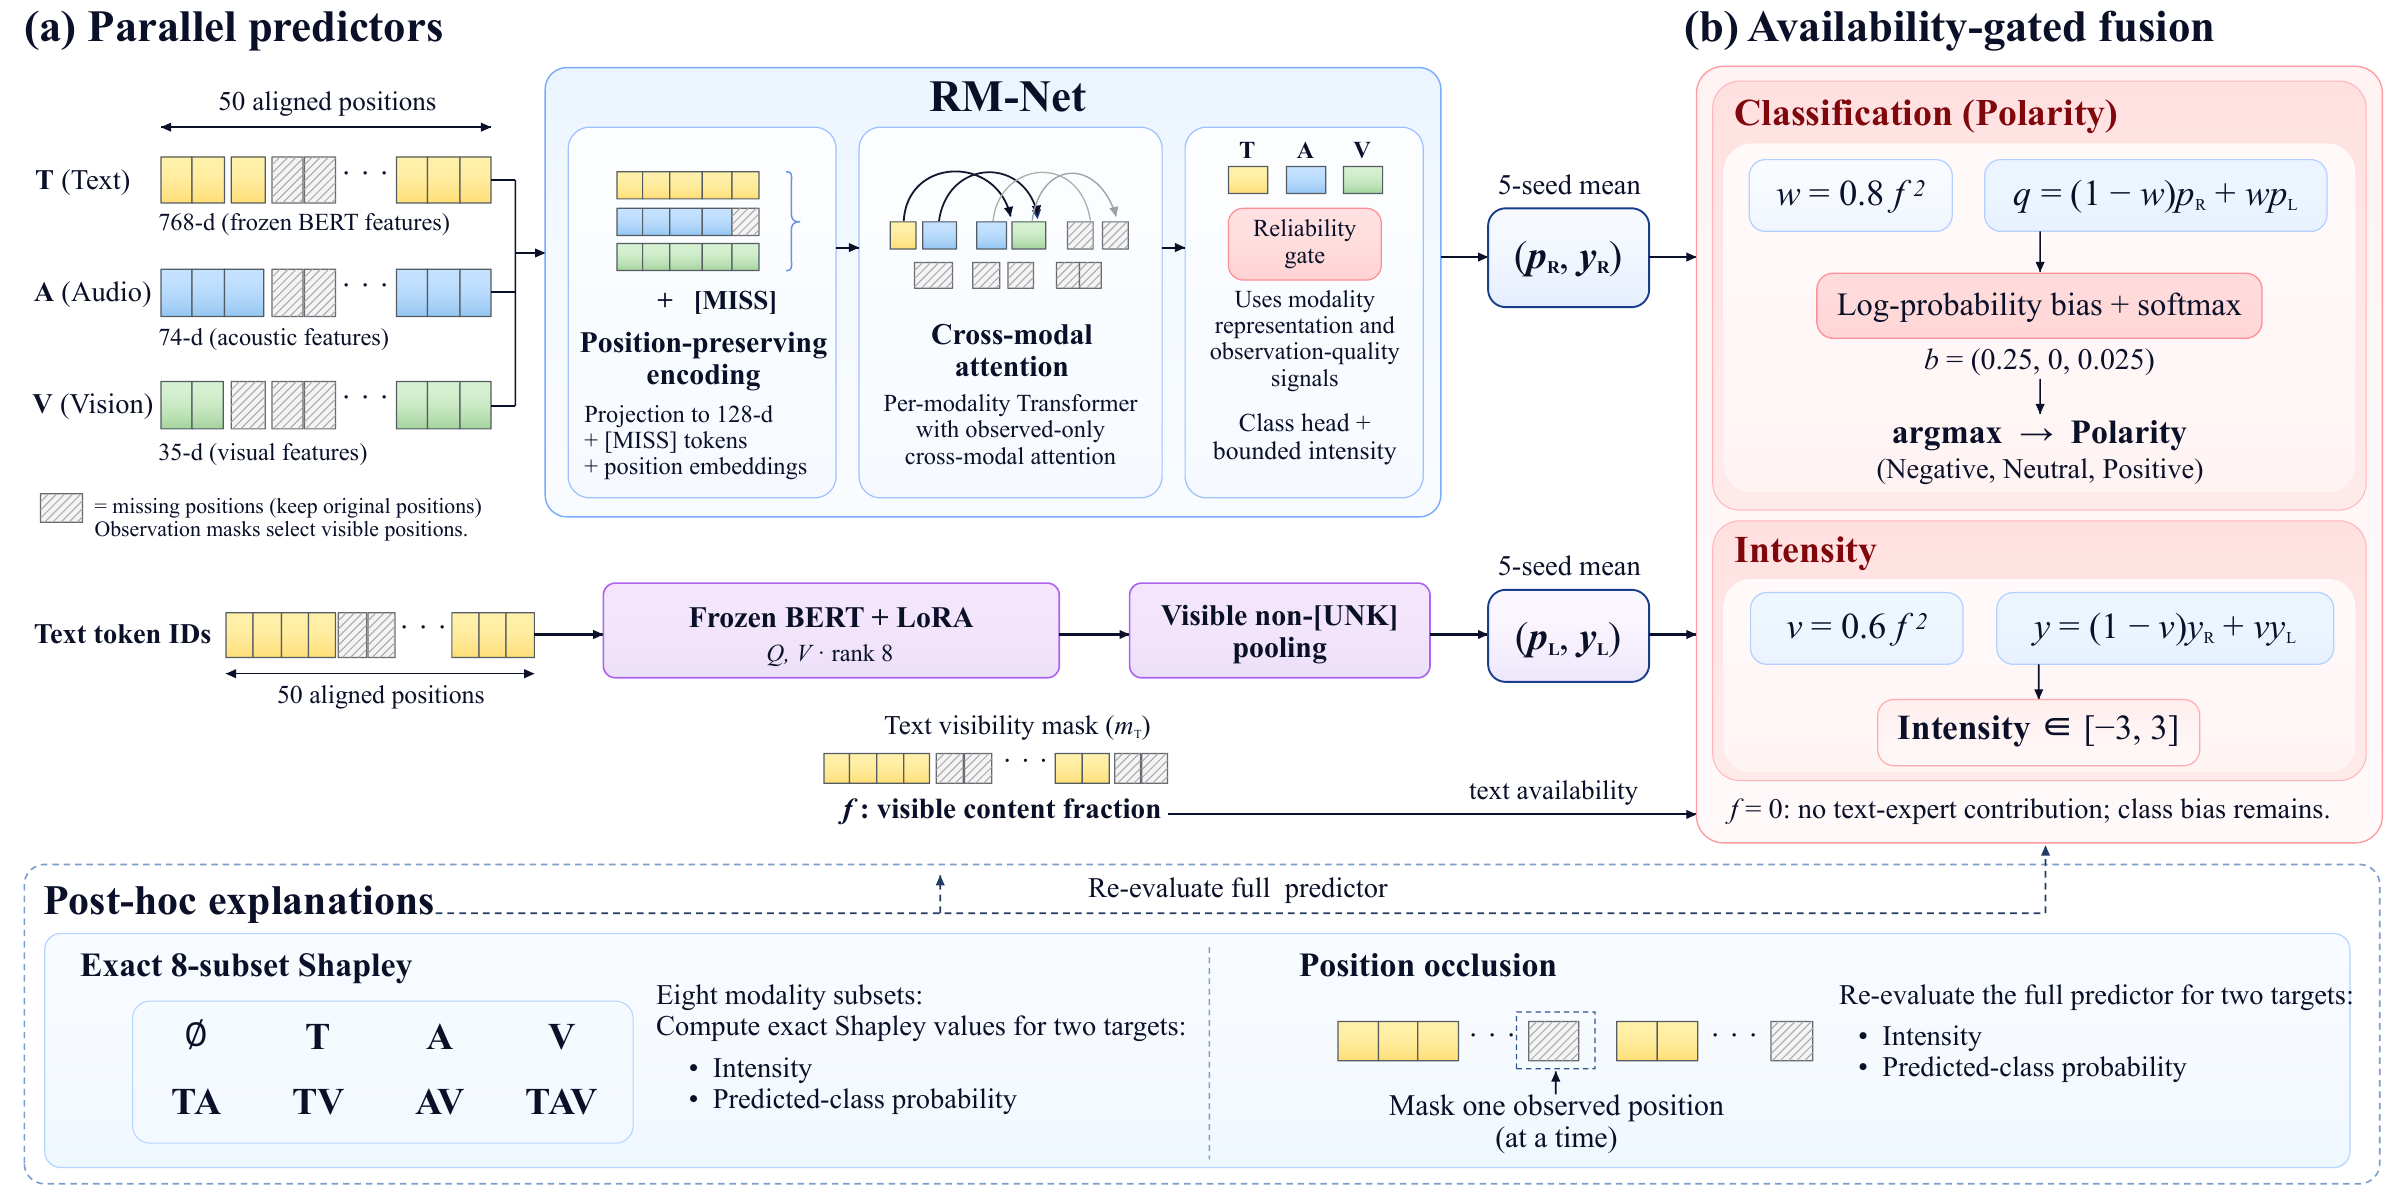
两条分支使用相同观测掩码,按可见文本比例融合,并分别解释类别概率与情感强度。
论文原图 PDF ↗4,850CMU-MOSEI 子集片段
5 + 5RM 核心与文本专家
85每个划分的评估条件
20 × 8专项样本与模态子集
研究任务
01 / RESEARCH实验结果
实验对照 →两视图平均 Macro-F10.6446
相对原 RM 辅助头提高 0.0238
清洁输入与 40% 混合缺失的指标均值| 输入条件 | Macro-F1 ↑ | Accuracy ↑ | MAE ↓ |
|---|---|---|---|
| 清洁输入 | 0.6550 | 0.6809 | 0.6099 |
| 40% 混合缺失 | 0.6341 | 0.6630 | 0.6210 |
727 条历史留出样本;测试结果曾被查看,不属于全新盲测。缺失实验采用编码后位置遮挡;附件 3 / 4 无真值标签。
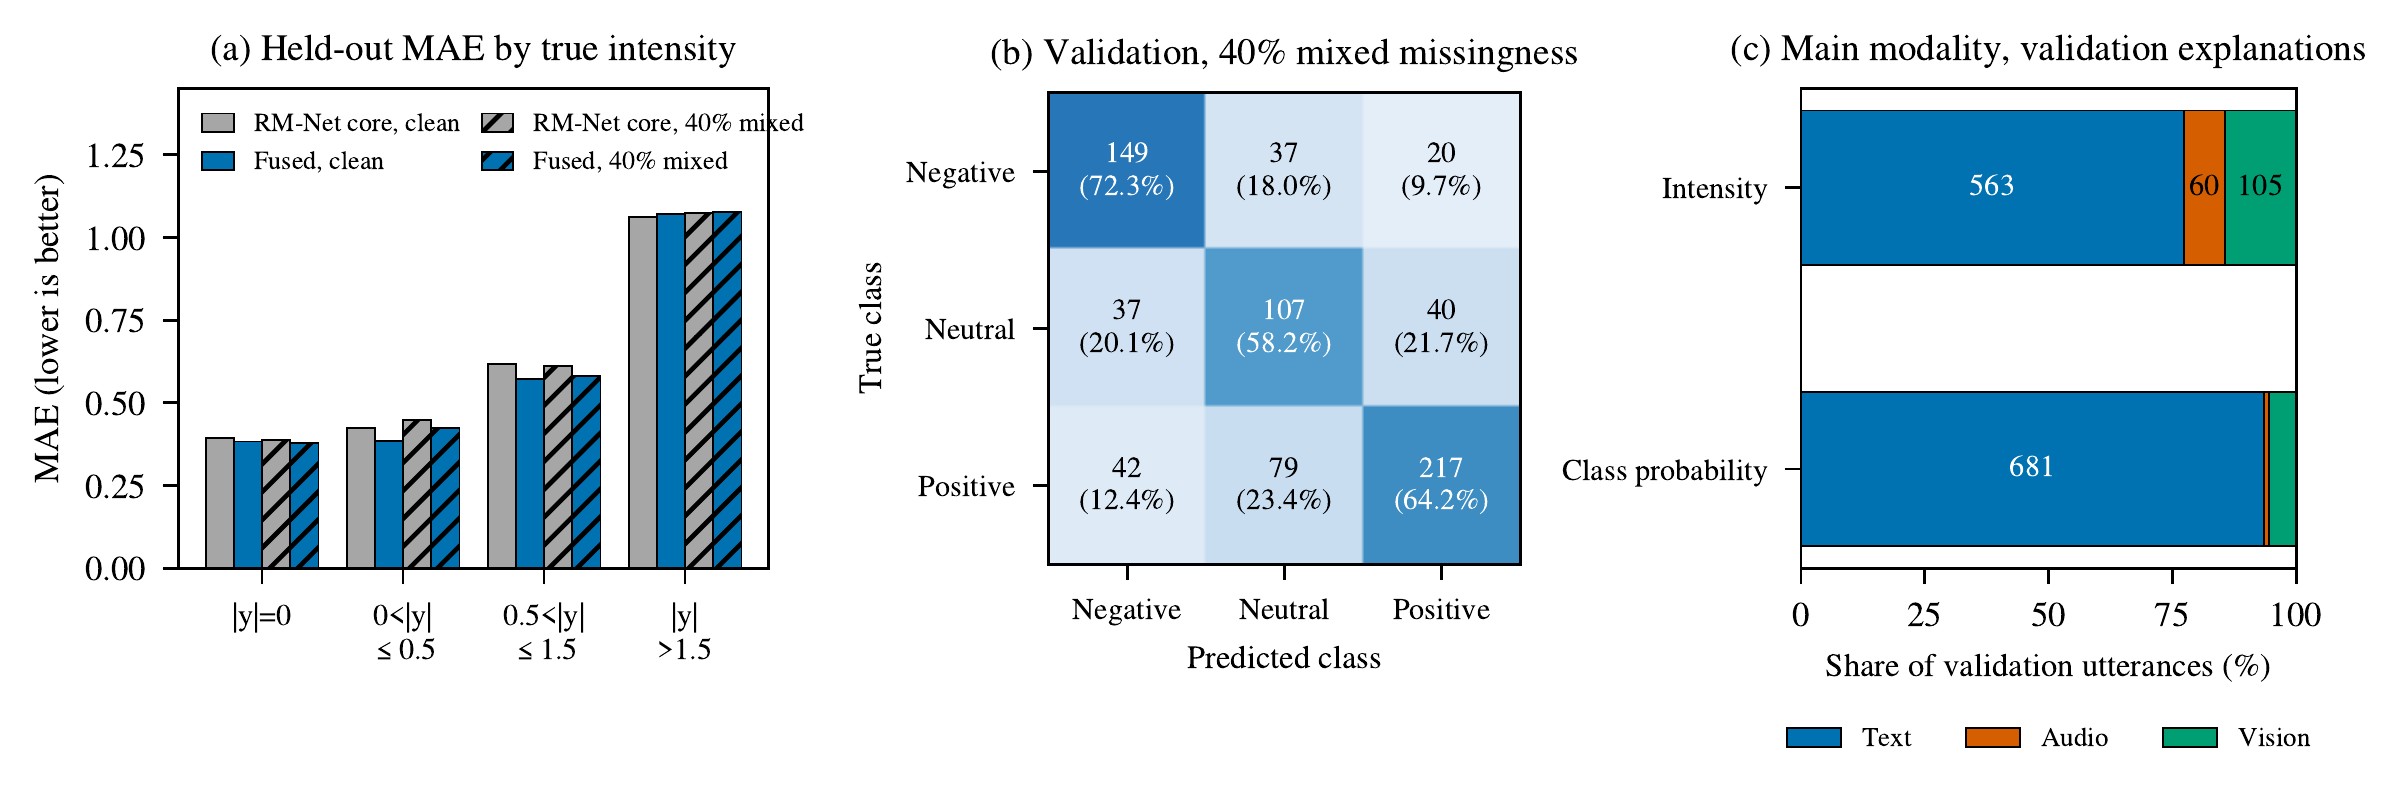
左:727 条留出话语按真实强度分组的 MAE。中:40% 混合缺失下的验证集混淆矩阵。右:728 条验证话语中,两种解释目标的主导模态计数。
论文原图 PDF ↗