预测解释
沿用冻结的融合预测器,分别解释情感强度与完整输入时的原预测类别概率。
研究动机
预测类别和连续强度由不同输出确定,二者的主要参考模态可能不同。本问固定两个解释目标,通过模态子集干预量化整体作用,再以逐位置遮挡定位局部证据。
模型内部的门控权重用于描述 RM 路径,不能代替完整融合模型的类别归因。解释结果描述模型的输入依赖,不构成真实情感成因的证明。
模态归因
枚举文本、语音、视觉的全部 8 个子集,重新计算 RM 输出、LoRA 池化及文本可用度权重,并求取精确 Shapley 值。强度归因以空输入强度为基准;分类归因固定完整输入时的预测类别。
F 分别表示融合强度或原预测类别概率。内部强度分解另行报告缩放后的三模态贡献、RM 交互项及 LoRA 贡献。
局部证据
对有效内容位置逐一遮挡。强度证据按输出绝对变化排序,分类证据按原预测类概率下降排序;PAD、CLS、SEP 不进入证据排序。局部效应包含上下文和融合权重变化,不能直接相加。
证据通过字符偏移、CTC 候选词时间及原始帧号映射回文本、语音时段和视频帧。时间映射单独核验,低可信对应保留标记。
结果分析
在 728 条验证样本上计算删除与保留曲线,并与五次随机排序比较。分类证据的归一化删除 AUC 提高 0.1126,表明删除所选位置对原预测类概率的影响更大。
| 目标 / 操作 | 所选 AUC | 随机 AUC |
|---|---|---|
| 强度 / 删除 | 0.2235 | 0.1136 |
| 强度 / 保留 | 0.1796 | 0.1659 |
| 类别概率 / 删除 | 0.1370 | 0.0244 |
| 类别概率 / 保留 | -0.0645 | 0.0365 |
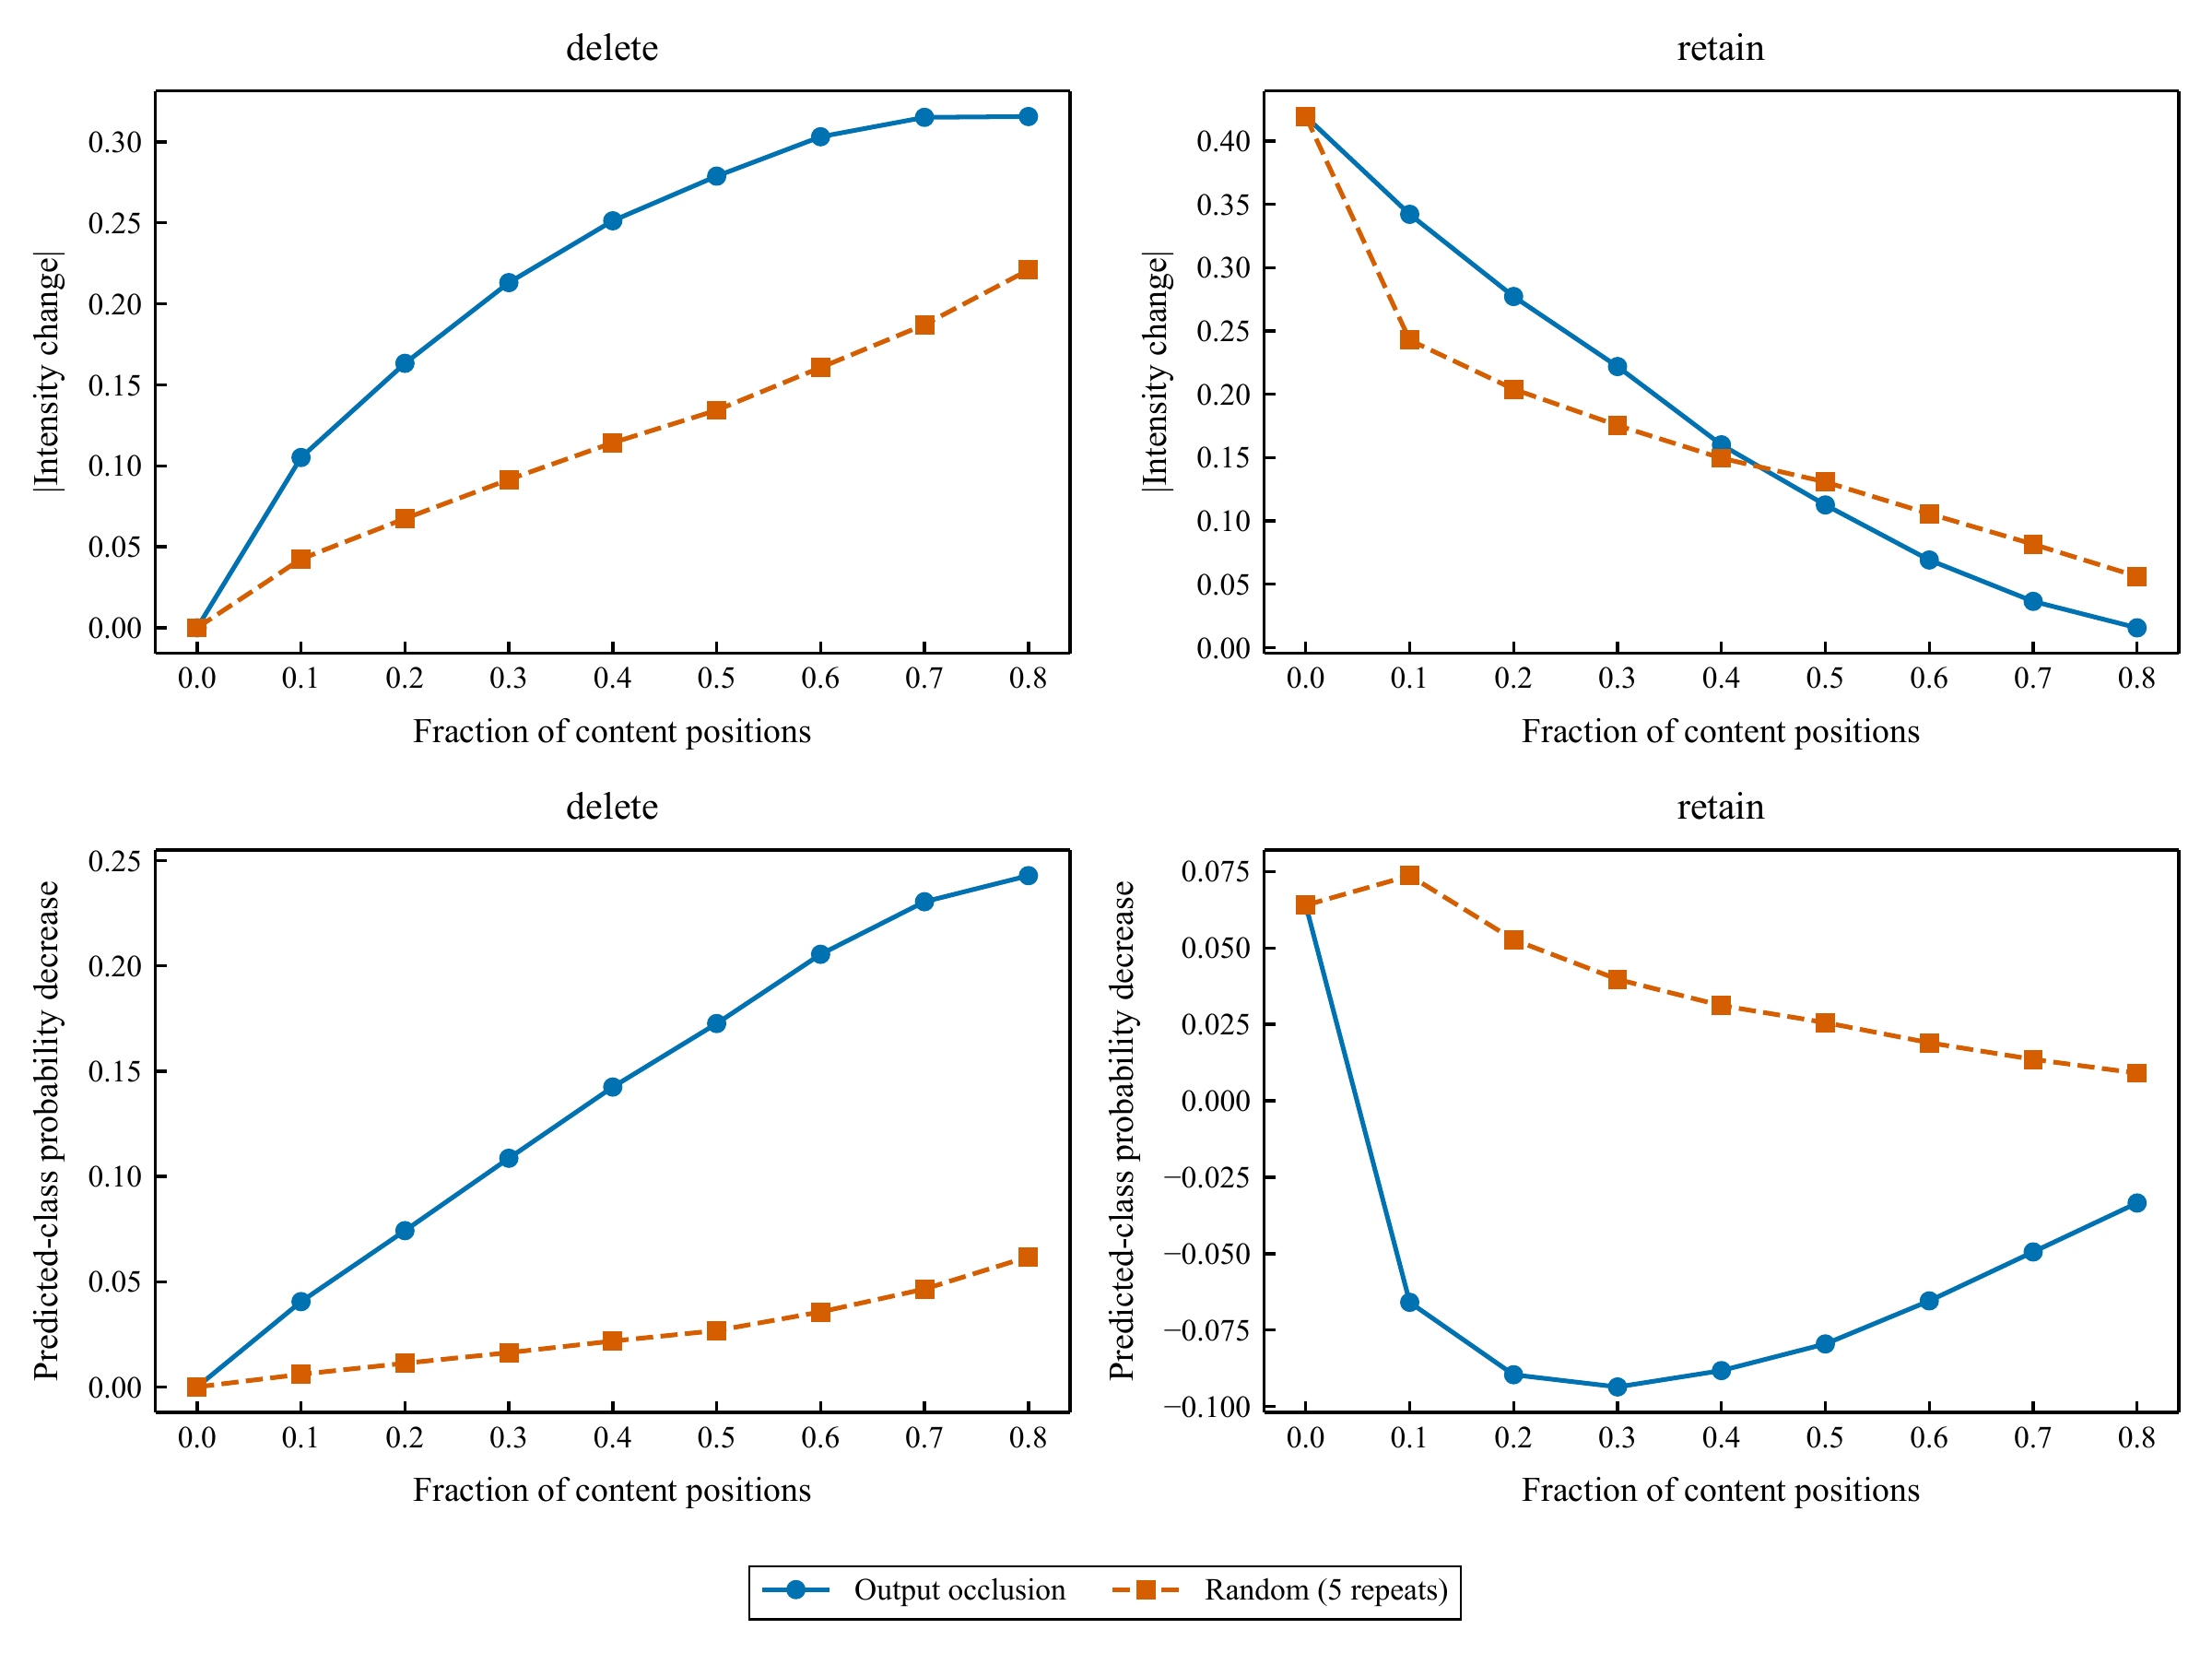
728 条验证话语,左列删除排名靠前的内容位置,右列仅保留这些位置。上排为强度绝对变化,下排为原预测类别概率下降;橙色虚线为五次随机排列的平均。
论文原图 PDF ↗强度保留 AUC 高于随机,说明所选排序的删除影响并不等同于少量证据的充分性。分类保留 AUC 为负表示原预测类概率上升,不能解释为准确率提高。
另对 728 组样本实施整词删除与重新编码:与编码后遮挡相比,有符号效应的 Spearman 相关系数为强度 0.6680、类别概率 0.2903。两种干预同时涉及上下文、位置及融合权重差异,不能互相替代。
样本分析
无标签集合 B(原附件 4)的 20 条样本均提供极性、强度与解释。论文图 10、11 展示同一个 19 号样本在类别概率和情感强度两个目标下的局部遮蔽效应。
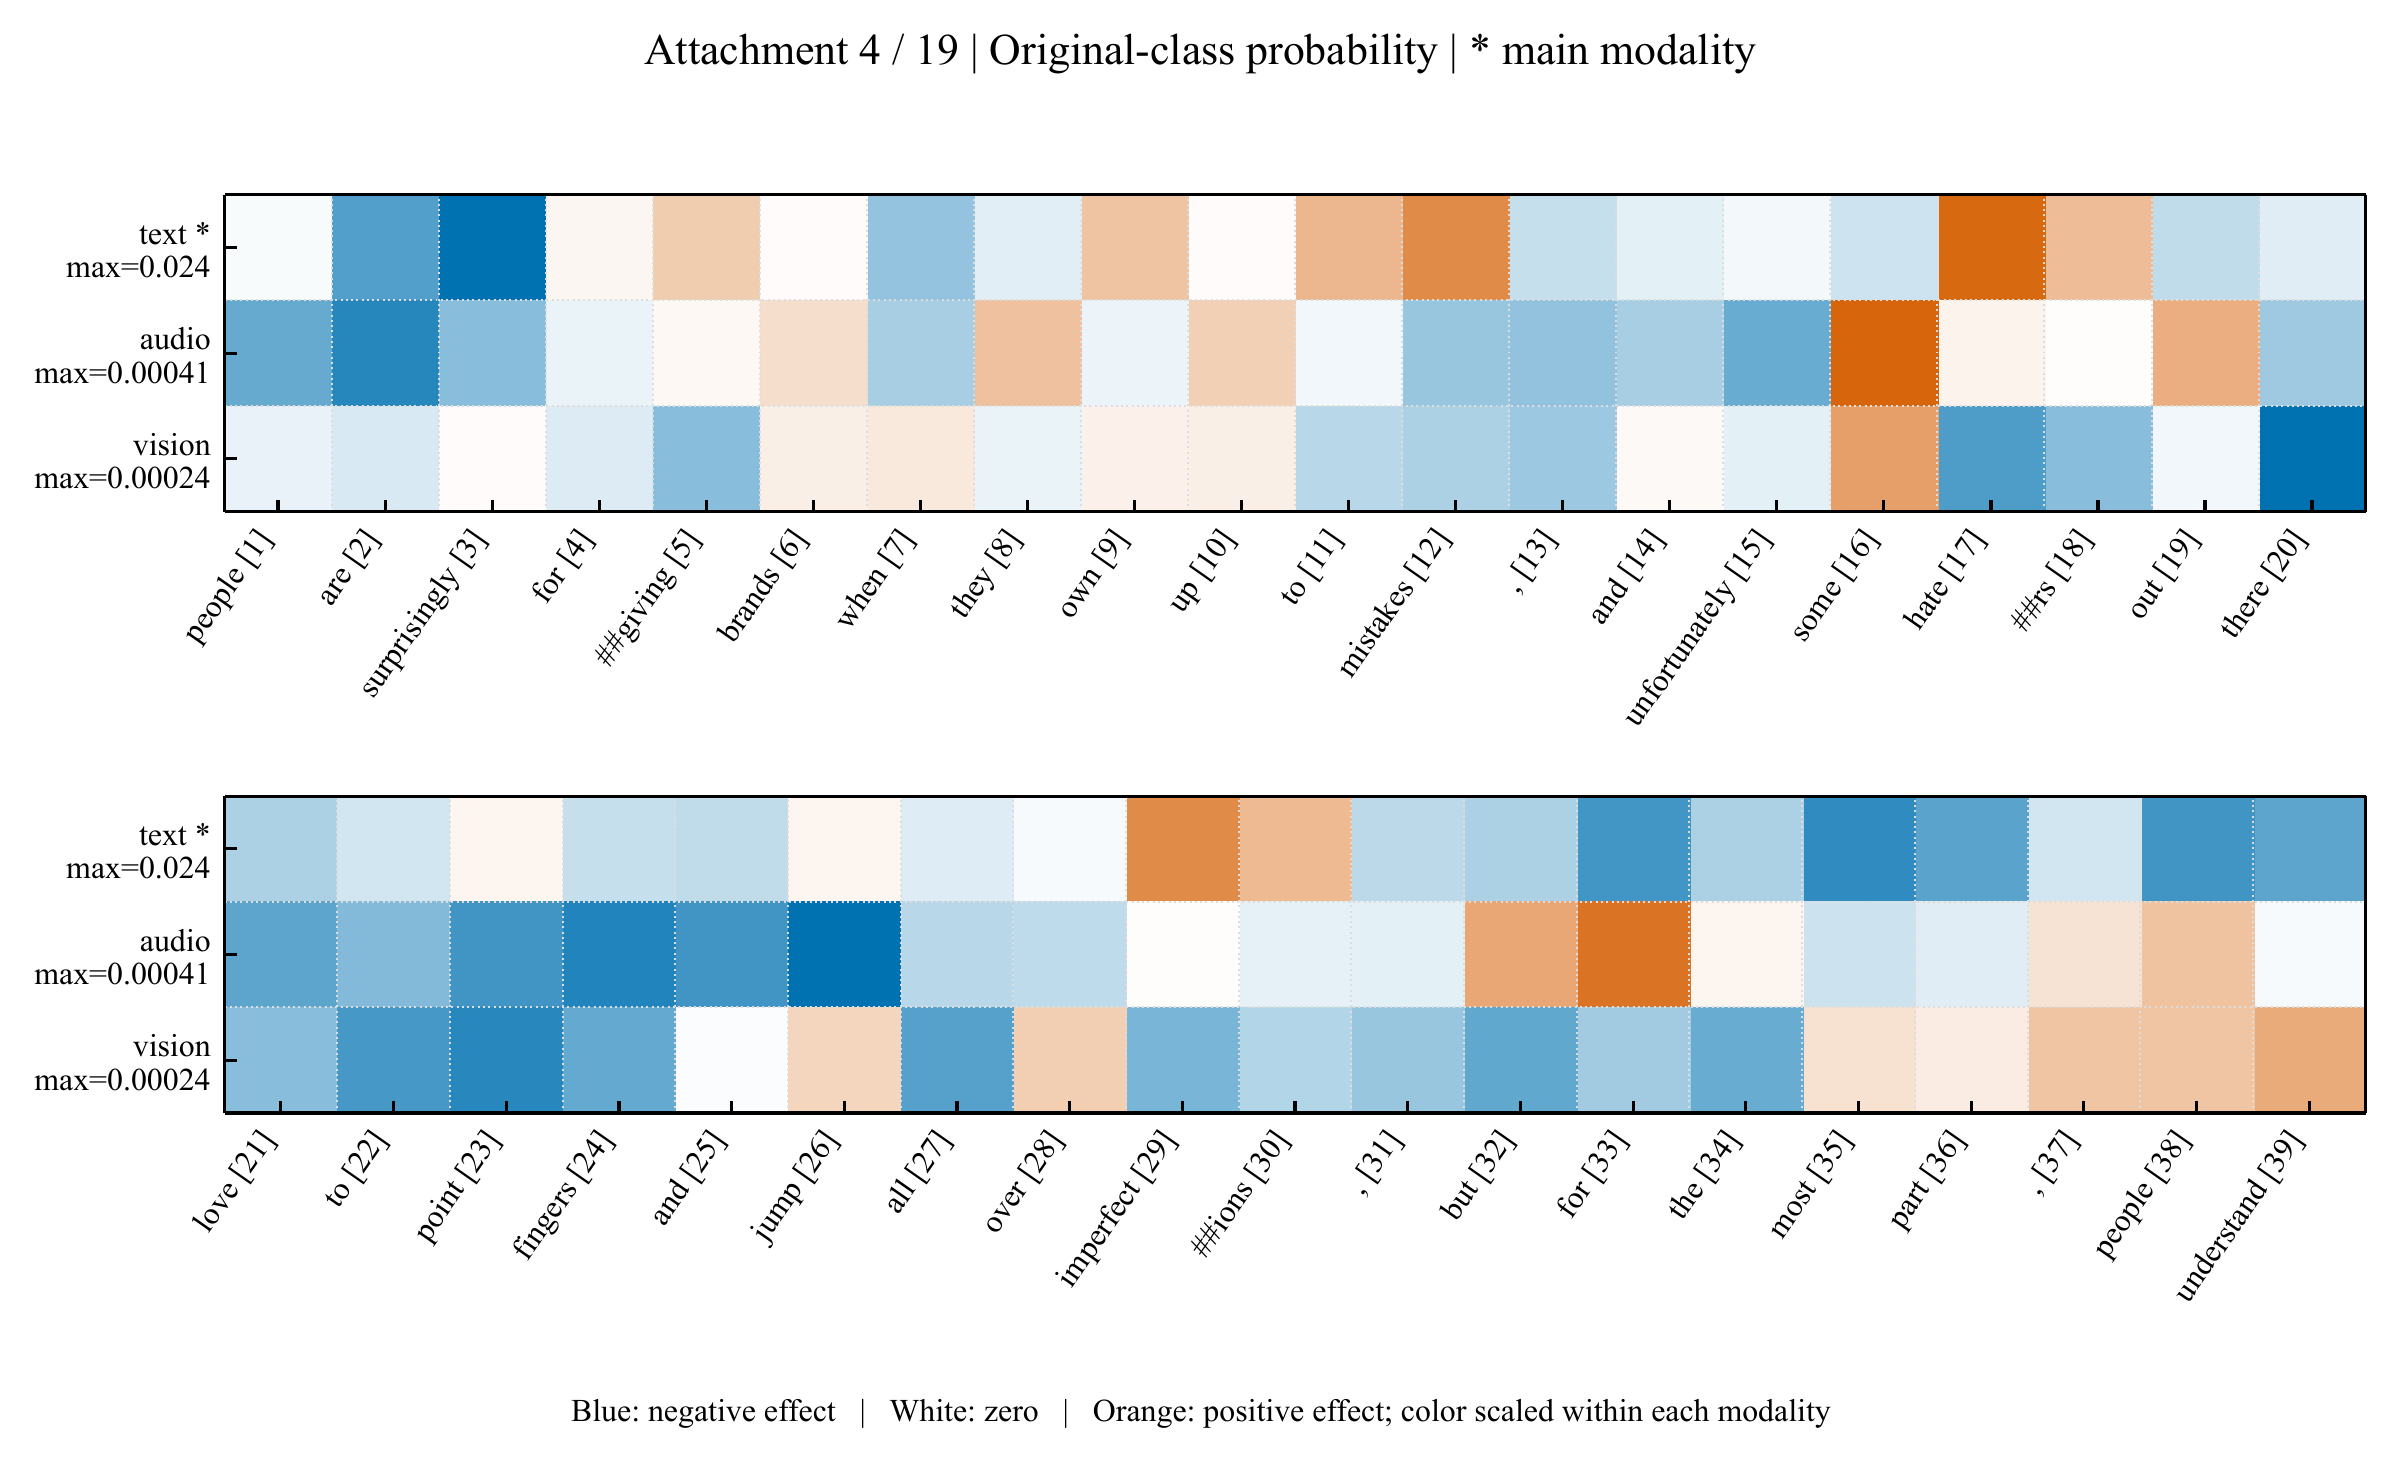
解释完整输入时的原预测类别概率,文本是该目标的主导模态。蓝色与橙色分别表示负、正局部效应;颜色在各模态内部独立缩放。
论文原图 PDF ↗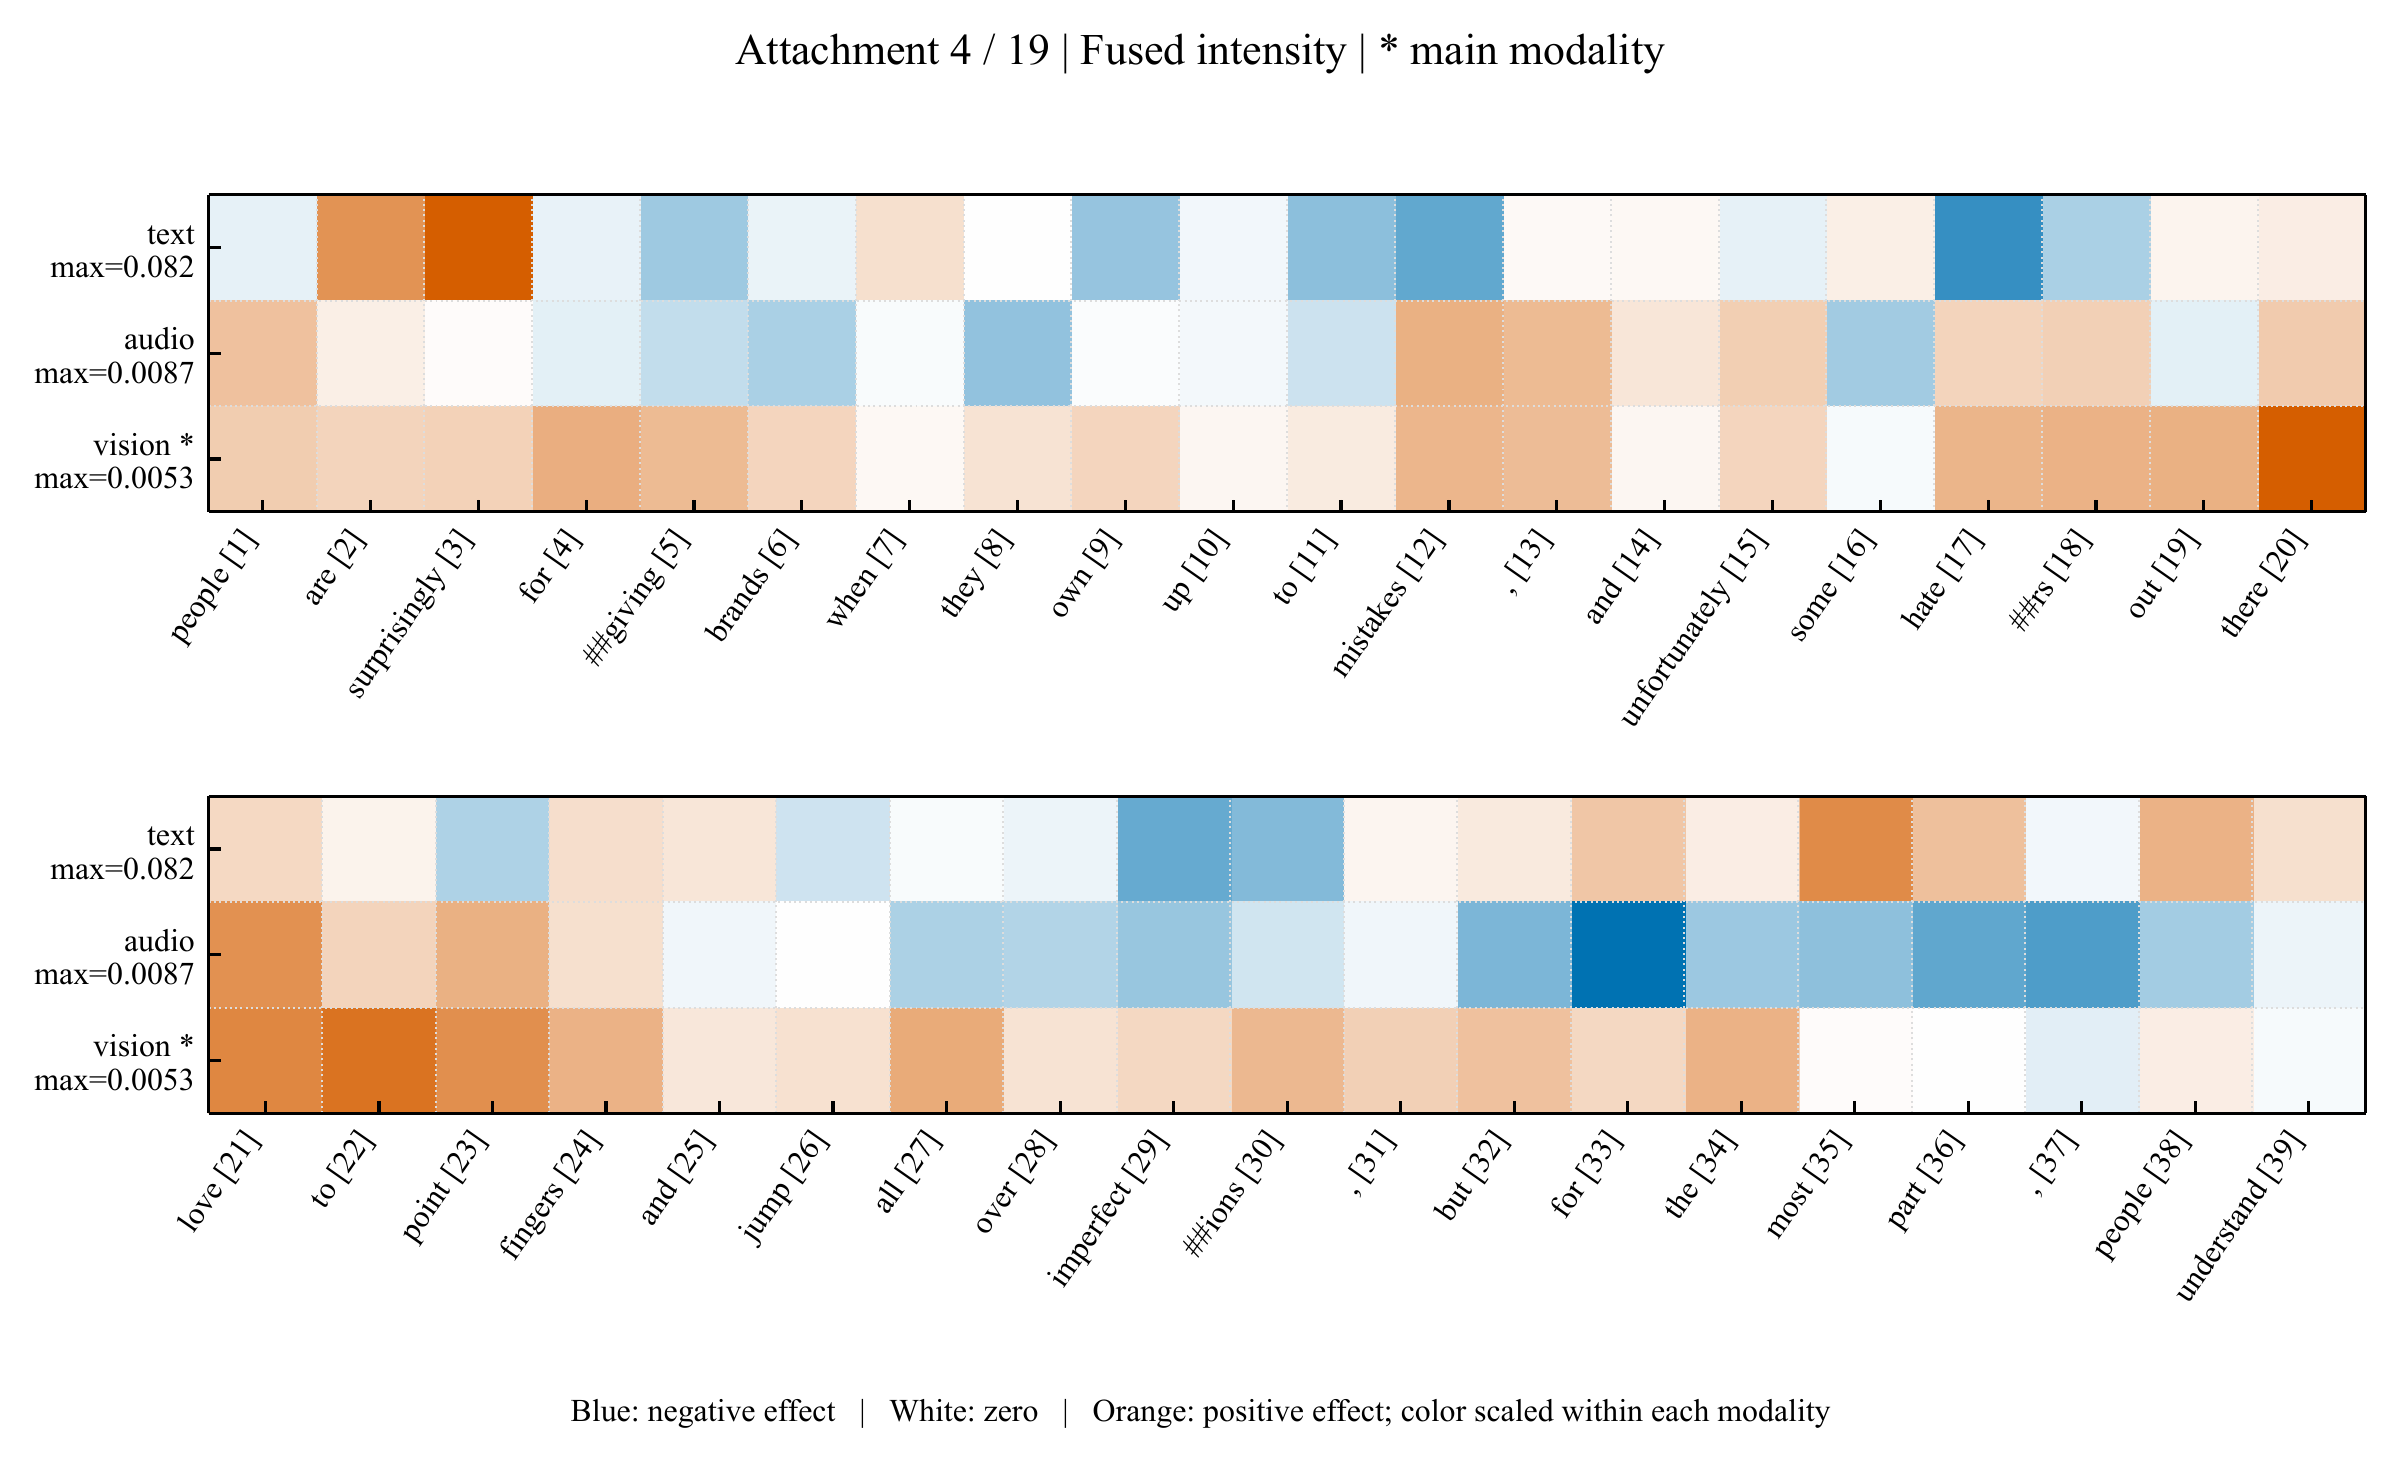
同一输入改用融合强度作为解释目标时,视觉成为主导模态。图内保留原始数据标识 Attachment 4 / 19;局部效应不能直接相加。
论文原图 PDF ↗附件 4 没有真值标签,解释用于检查模型行为,不用于评估预测准确率。