FEATURE ALIGNMENT
特征提取与时序对齐
以附件 1 的原始视频和给定转写为输入,构建可追溯的三模态时序特征。
研究动机
文本、语音与视觉具有不同的采样粒度,按序列位置直接拼接会产生时间对应误差。本问以候选词区间为对齐单位,分别记录特征的数值可用性与时间对应质量。
全部 100 条样本及原始标签均予保留。预训练模型参数固定,标签不参与特征提取或质量阈值选择。
特征表示
| 模态 | 维数 | 特征定义 |
|---|---|---|
| 文本 | 768 | 冻结 BERT 上下文特征,按原词对应的 WordPiece 均值池化。 |
| 语音 | 74 | 韵律、音质、频谱、共振峰与倒谱特征。 |
| 视觉 | 35 | 27 项表情形变系数、3 项姿态及 5 项几何或动态指标。 |
L0 保留原始帧级特征与来源索引;L1 保存完整的变长词序列;L2 提供定长张量及有效位置掩码。定长接口的截断不影响 L0、L1 的完整记录。
时序对齐
采用 wav2vec 2.0 的声学后验进行 CTC 强制对齐,估计候选词区间,并在音视频共同有效时段内汇聚声学帧和有效人脸帧。时间门控同时要求词后验不低于 0.5、样本平均词后验不低于 0.5、转写词错误率不高于 0.5。
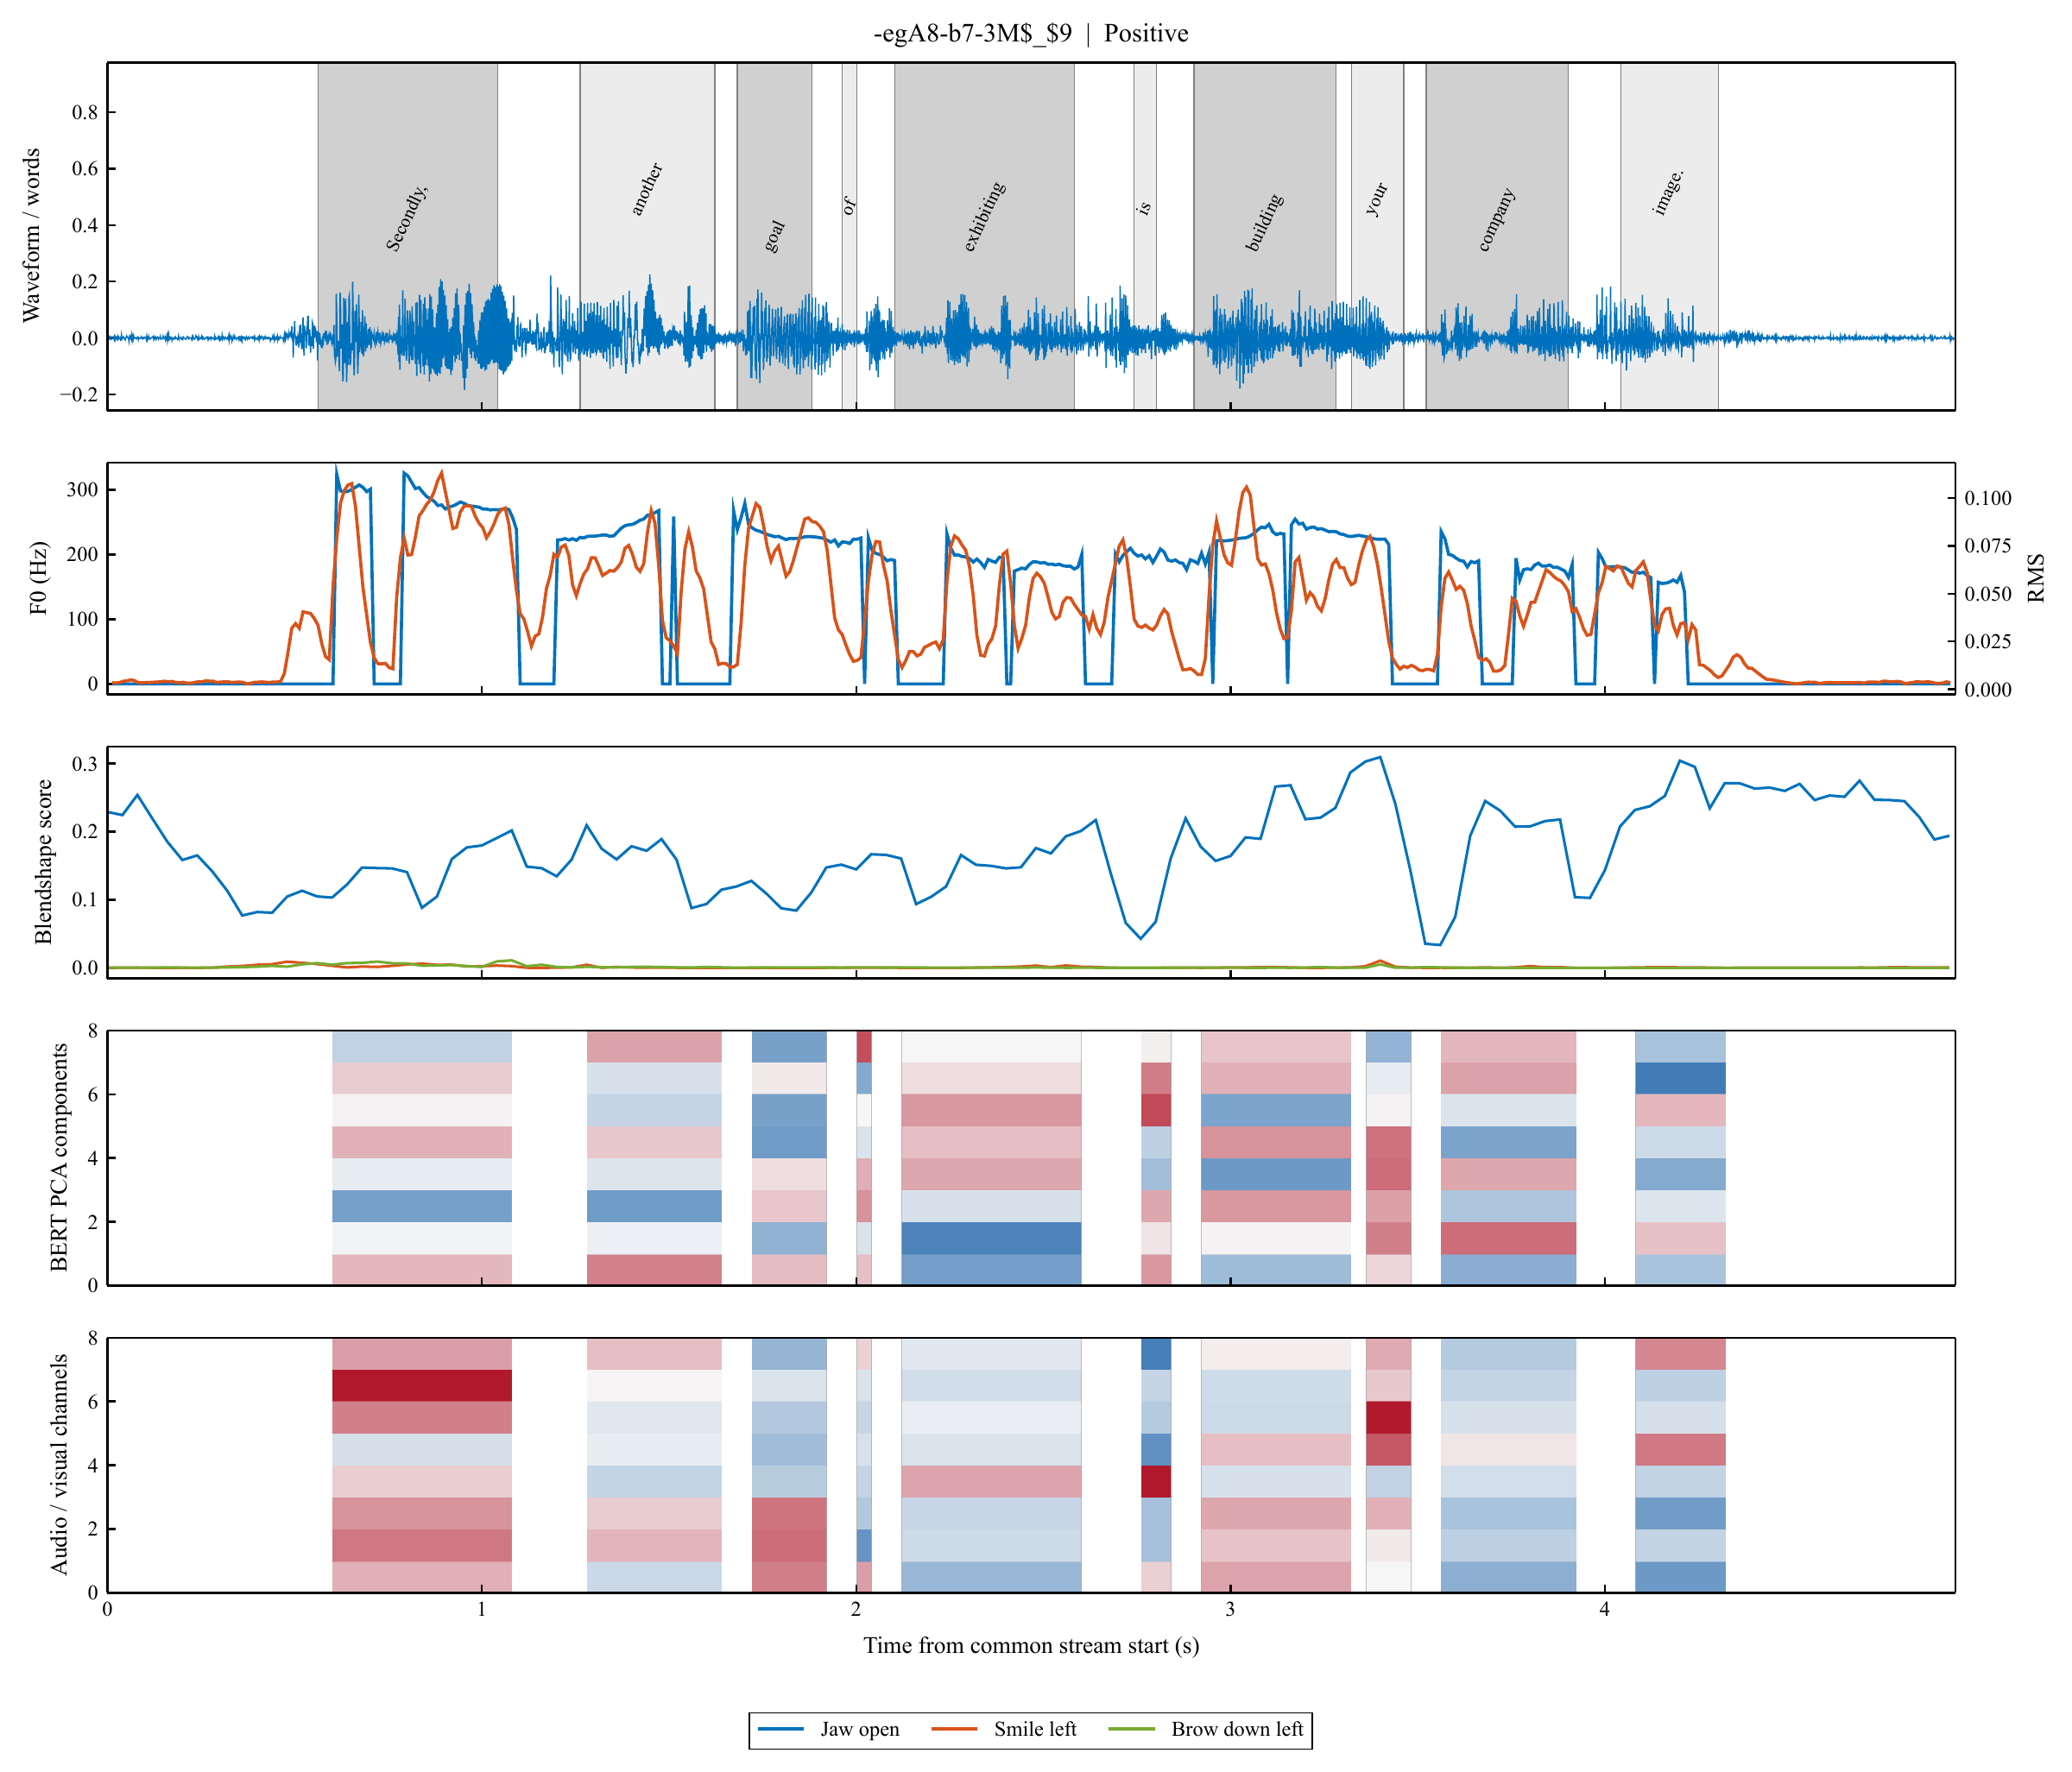
4.9 秒正向片段的 CTC 候选词区间,以及对应的声学、视觉和 BERT 特征。阴影标记词边界,各子图纵轴采用各自单位。
论文原图 PDF ↗结果分析
| 核验项目 | 结果 |
|---|---|
| 样本覆盖 | 100 / 100 |
| 完整词数 | 1,926 |
| 声学帧 / 视觉帧 | 77,509 / 19,474 |
| 时间门控通过词数 | 1,316 / 1,926 |
| 帧加权人脸检出率 | 81.97% |
| 独立重复提取一致性 | 500 / 500 |
通过时间门控的 1,316 个词来自 65 条样本;其余 610 个词保留特征,但屏蔽低可信时间对应。两次独立提取的 500 份特征与映射记录完全一致,最大数值差为 0。
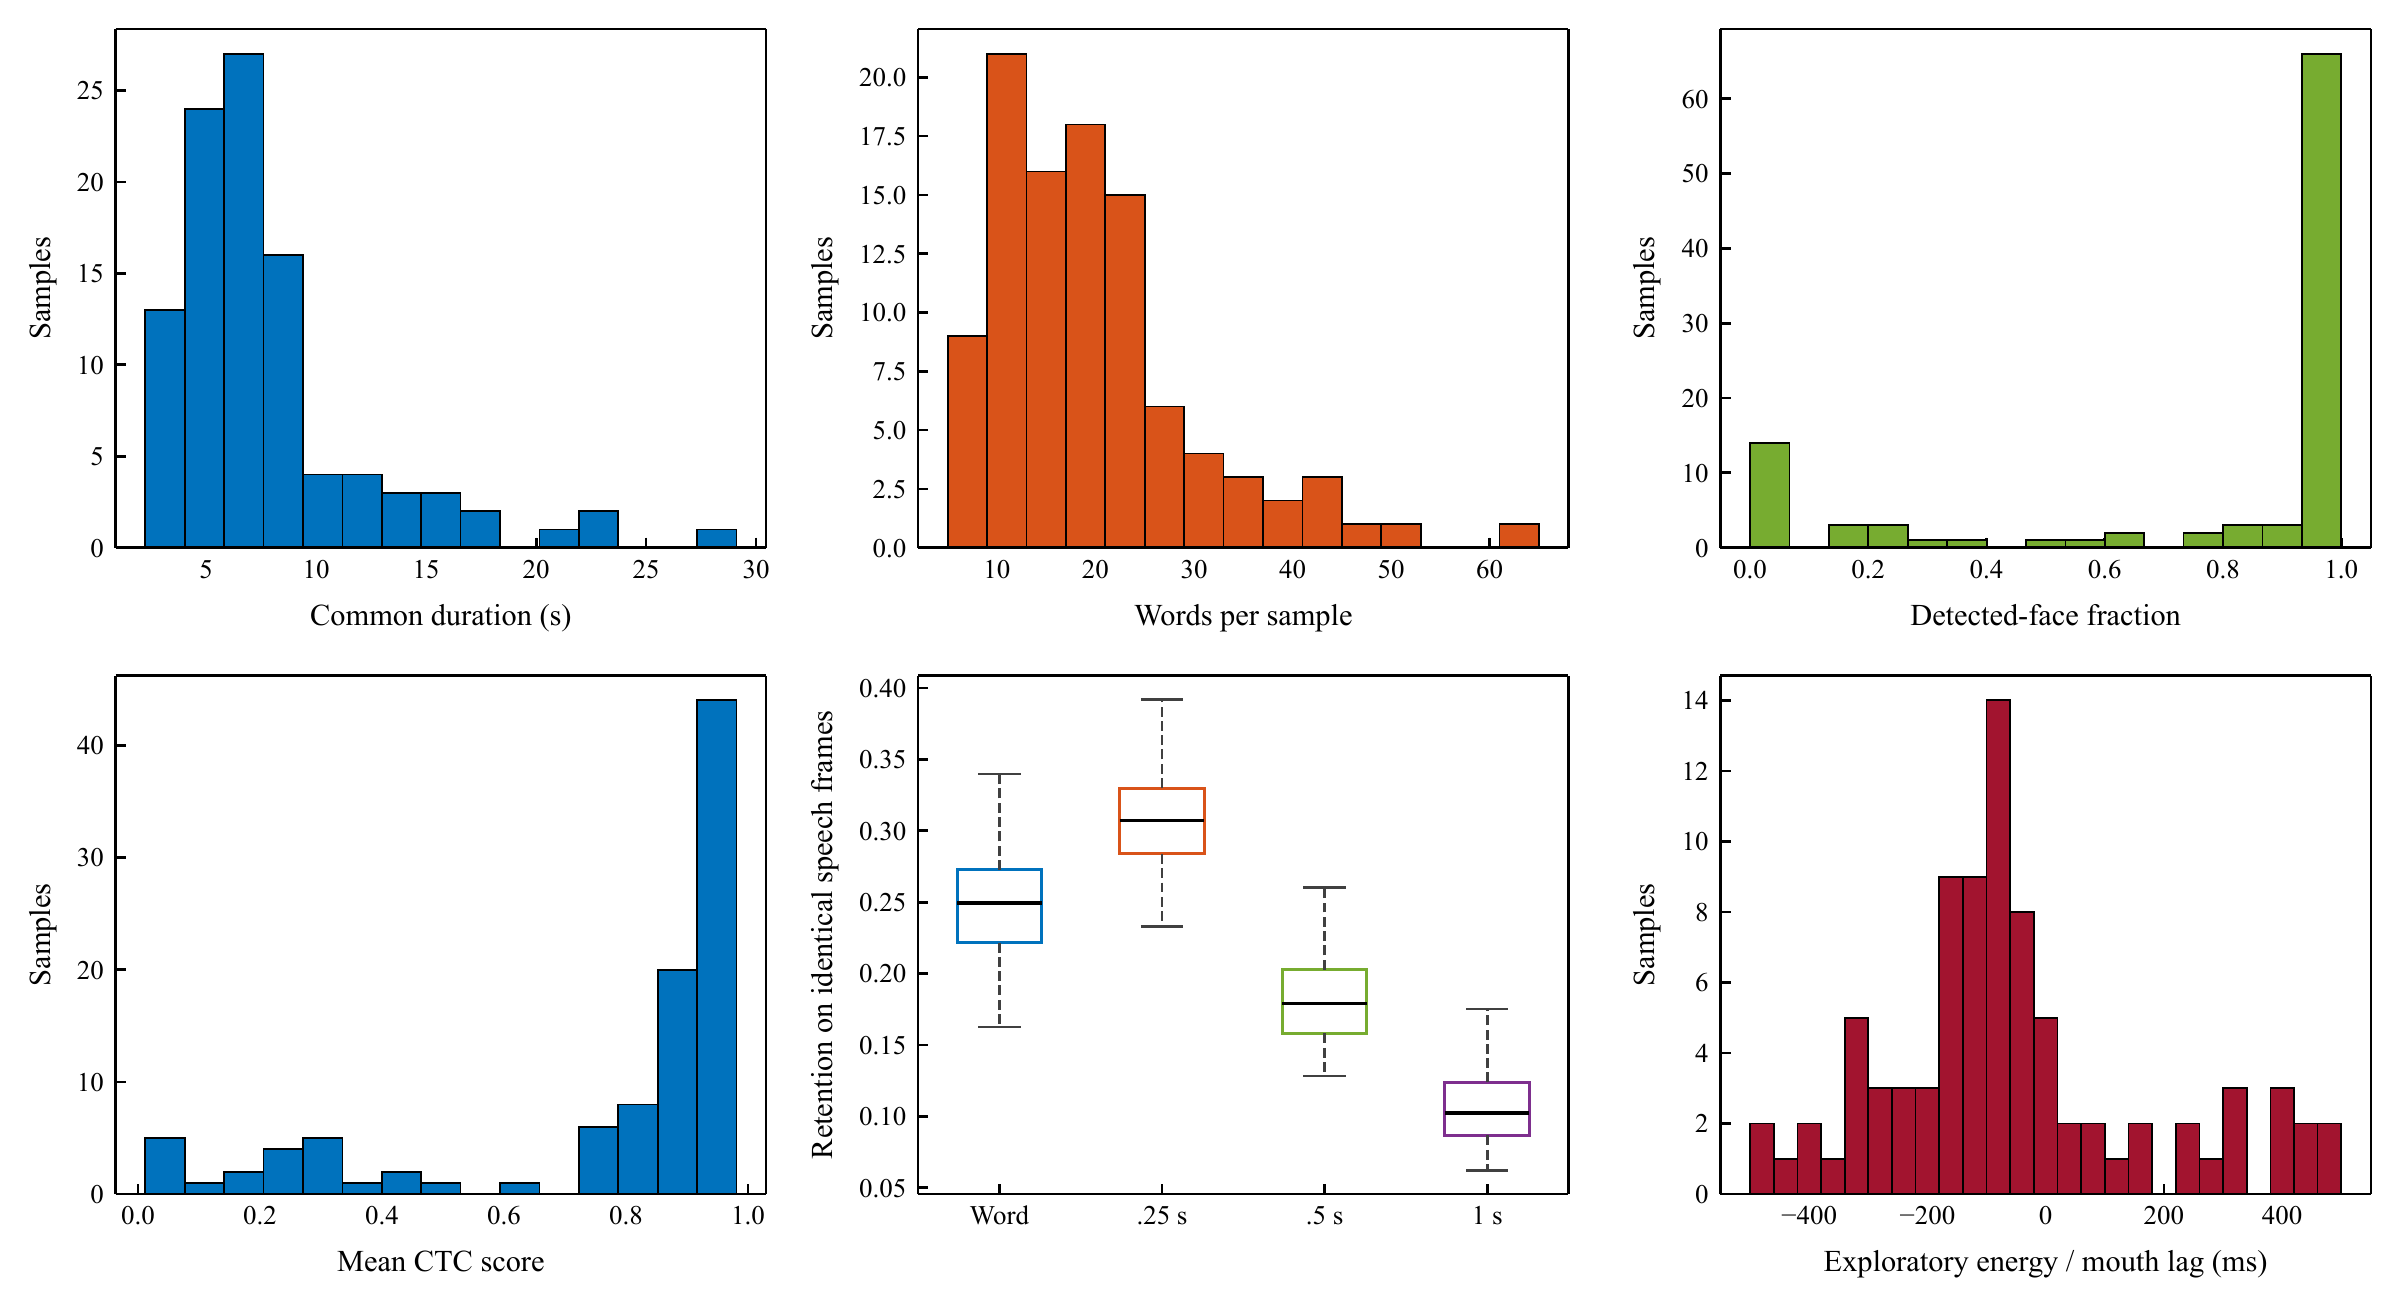
100 个片段的共同时间轴长度、词数、人脸检出率与 CTC 后验;声学方差统计基于至少一个词通过门控的 65 个片段。右下的声画时滞仅为探索性分析,不用于调整时间轴。
论文原图 PDF ↗在相同可信声学帧上,词级平均信息保留率为 0.2489,0.25 秒固定窗为 0.3120。词级组织提供语义对应,但不保证最高的数值信息保留率。门控覆盖率和数值一致性均不能替代人工词边界准确率。
自提取特征与预测模型使用的预提取特征分布不同。预测与解释使用后者,本流程用于独立的特征构建与质量核验。