情感强度
八子集 Shapley 解释相对空输入的强度变化;内部可加分解显式保留 LoRA 贡献。
针对局部连续片段缺失,构建可靠性感知多模态网络,并融合 BERT LoRA 文本专家。分类与回归分别预测情感极性和连续强度。
局部连续缺失同时改变可用信息与观测分布。为保留三模态的原始对齐关系,模型保留缺失位置,通过观测掩码区分非零观测与缺失位置;有效长度内的全零观测也被视为未观测,并从可见模态读取补充信息。
使用 CMU-MOSEI 衍生子集的 aligned_50 预提取特征,训练 / 验证 / 历史留出划分为 3,395 / 728 / 727。词级对齐辅助流程的自提取特征不进入预测模型。
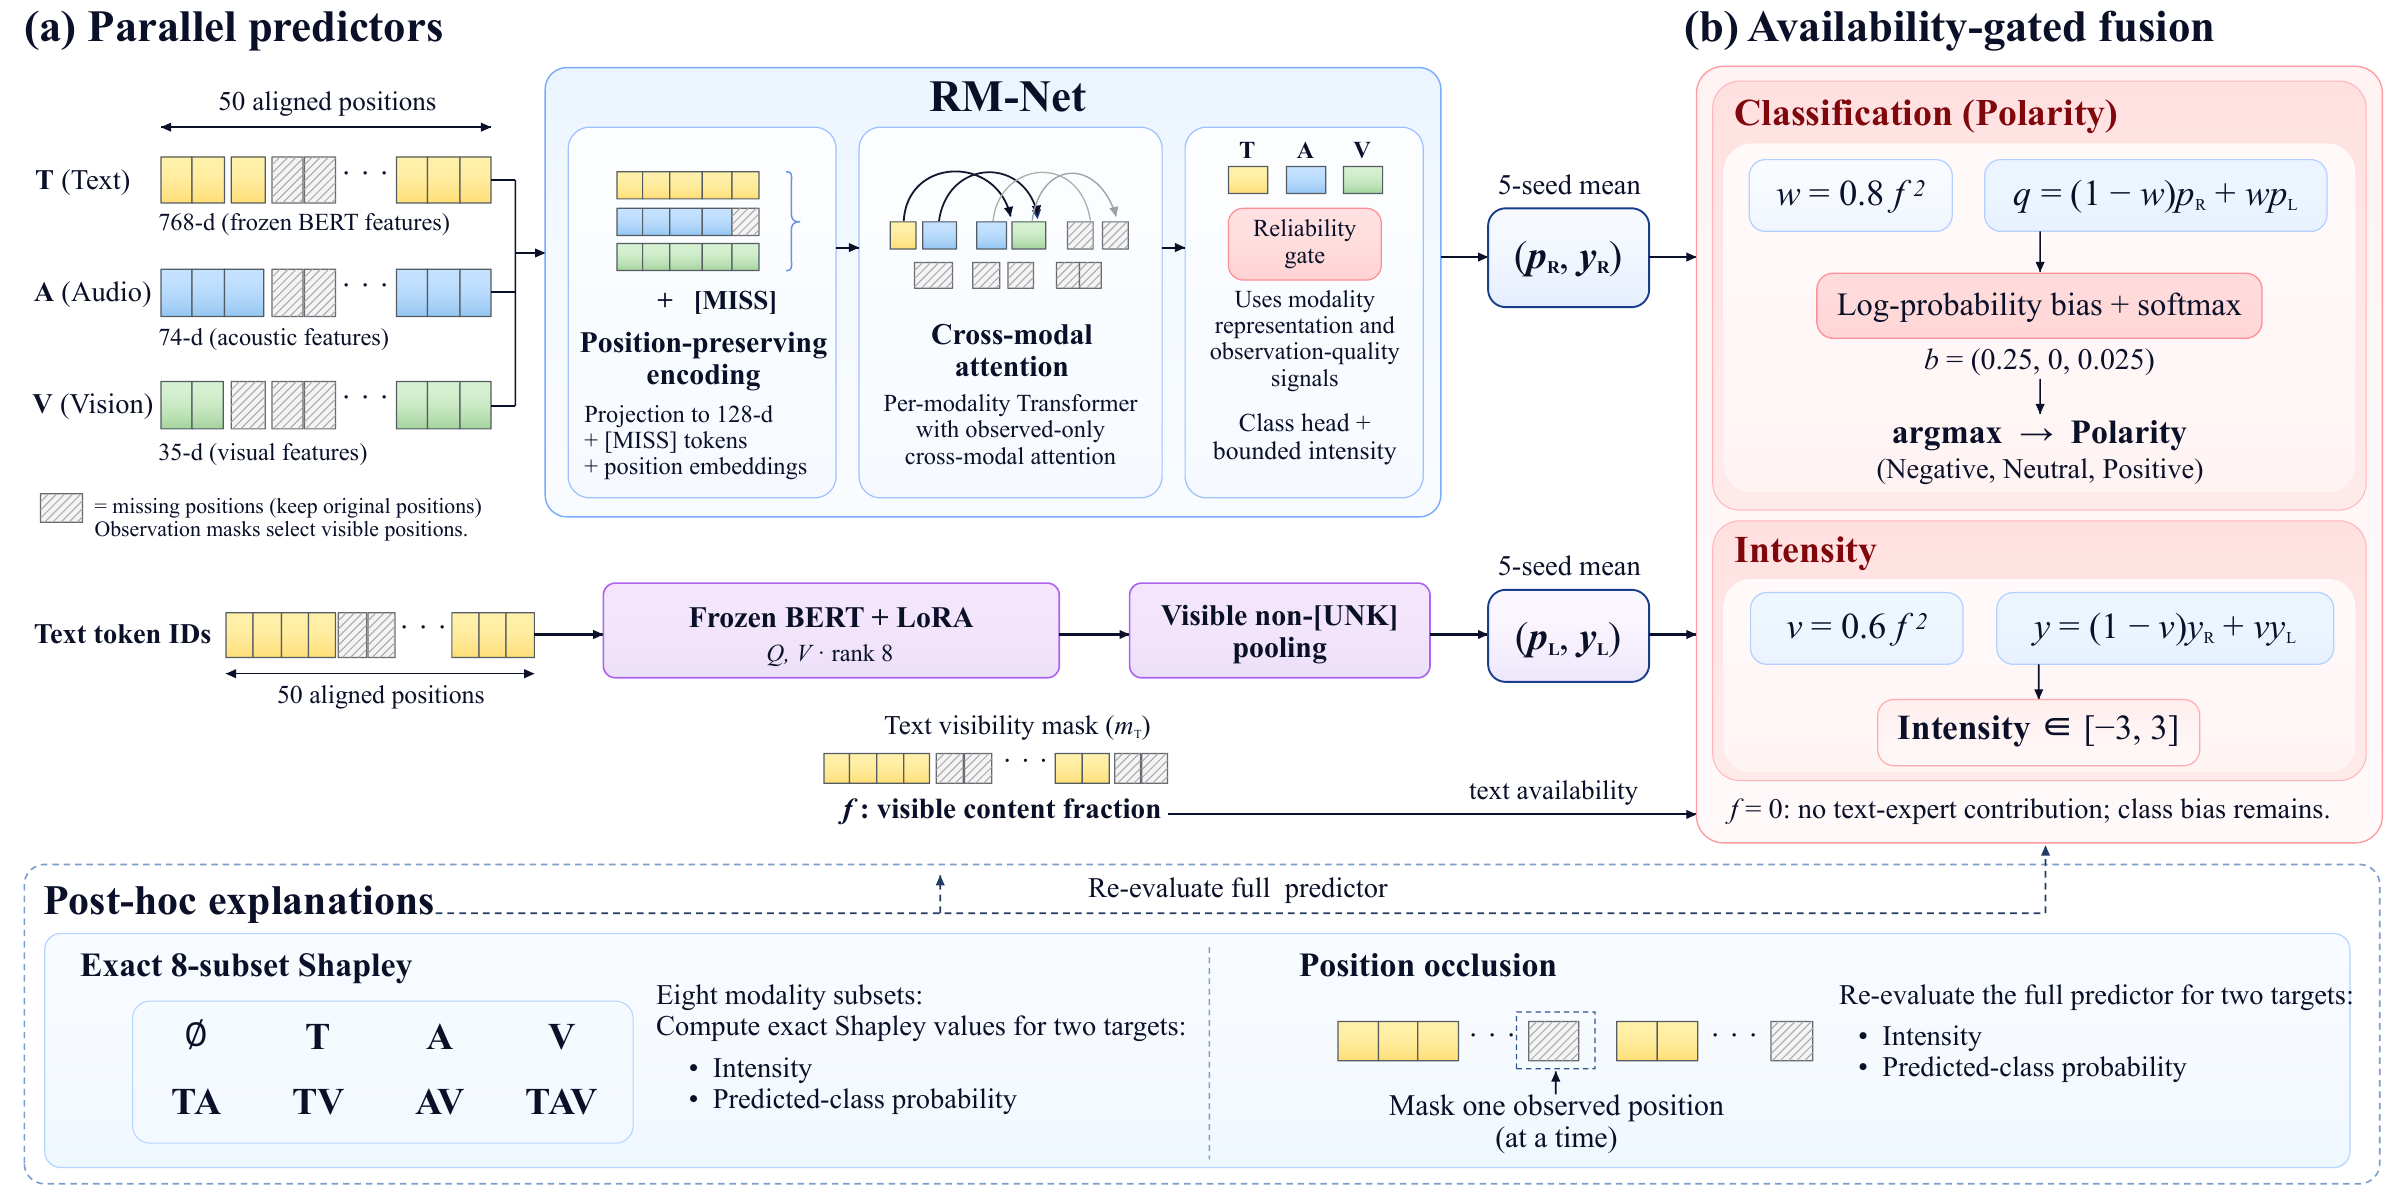
两条分支使用相同观测掩码,按可见文本比例融合,并分别解释类别概率与情感强度。
论文原图 PDF ↗原始观测与人工遮挡后的受损观测构成两个视图,共享 RM-Net 参数。联合目标包含极性与强度监督、人工遮挡位置的特征重建及视图一致性约束。
渐进式片段遮挡用于构造受损视图:训练前 30% 阶段将缺失率上限从 0.3 逐步提高至 1;每次选择 1–3 个模态、1–2 段连续区间,并以 20% 概率保留原视图。
原有缺失不作为重建目标,一致性分支采用停止梯度。模型总览见论文图 1。
令 f 为有效内容位置中可见且非 UNK 的比例。分类与回归采用独立的文本专家权重,最终类别由概率最大项决定。
类别顺序:负向、中性、正向。
滑块表示固定融合公式中权重随文本可用比例的变化。
f = 0 时专家权重为零,回归退回 RM 强度;分类仍保留固定偏置。各模型先 softmax 再平均,不平均 logits。独立分类与回归允许出现“强度为正、类别为中性”。
固定验证集选择的融合参数,在清洁输入和 40% 混合缺失条件下评估同一模型。下表数值直接读取网站保存的冻结评估记录。
| 划分 | 条件 | Accuracy ↑ | Macro-F1 ↑ | MAE ↓ | Pearson r ↑ |
|---|---|---|---|---|---|
| 验证集 | 清洁输入 | 0.6442 | 0.6339 | 0.5652 | 0.6835 |
| 验证集 | 40% 混合缺失 | 0.6497 | 0.6394 | 0.5722 | 0.6638 |
| 历史留出集 | 清洁输入 | 0.6809 | 0.6550 | 0.6099 | 0.6942 |
| 历史留出集 | 40% 混合缺失 | 0.6630 | 0.6341 | 0.6210 | 0.6861 |
历史留出集两视图平均 Macro-F1 为 0.6446,较原 RM 辅助头提高 0.0238。历史测试结果曾参与开发观察,不能视为全新盲测。
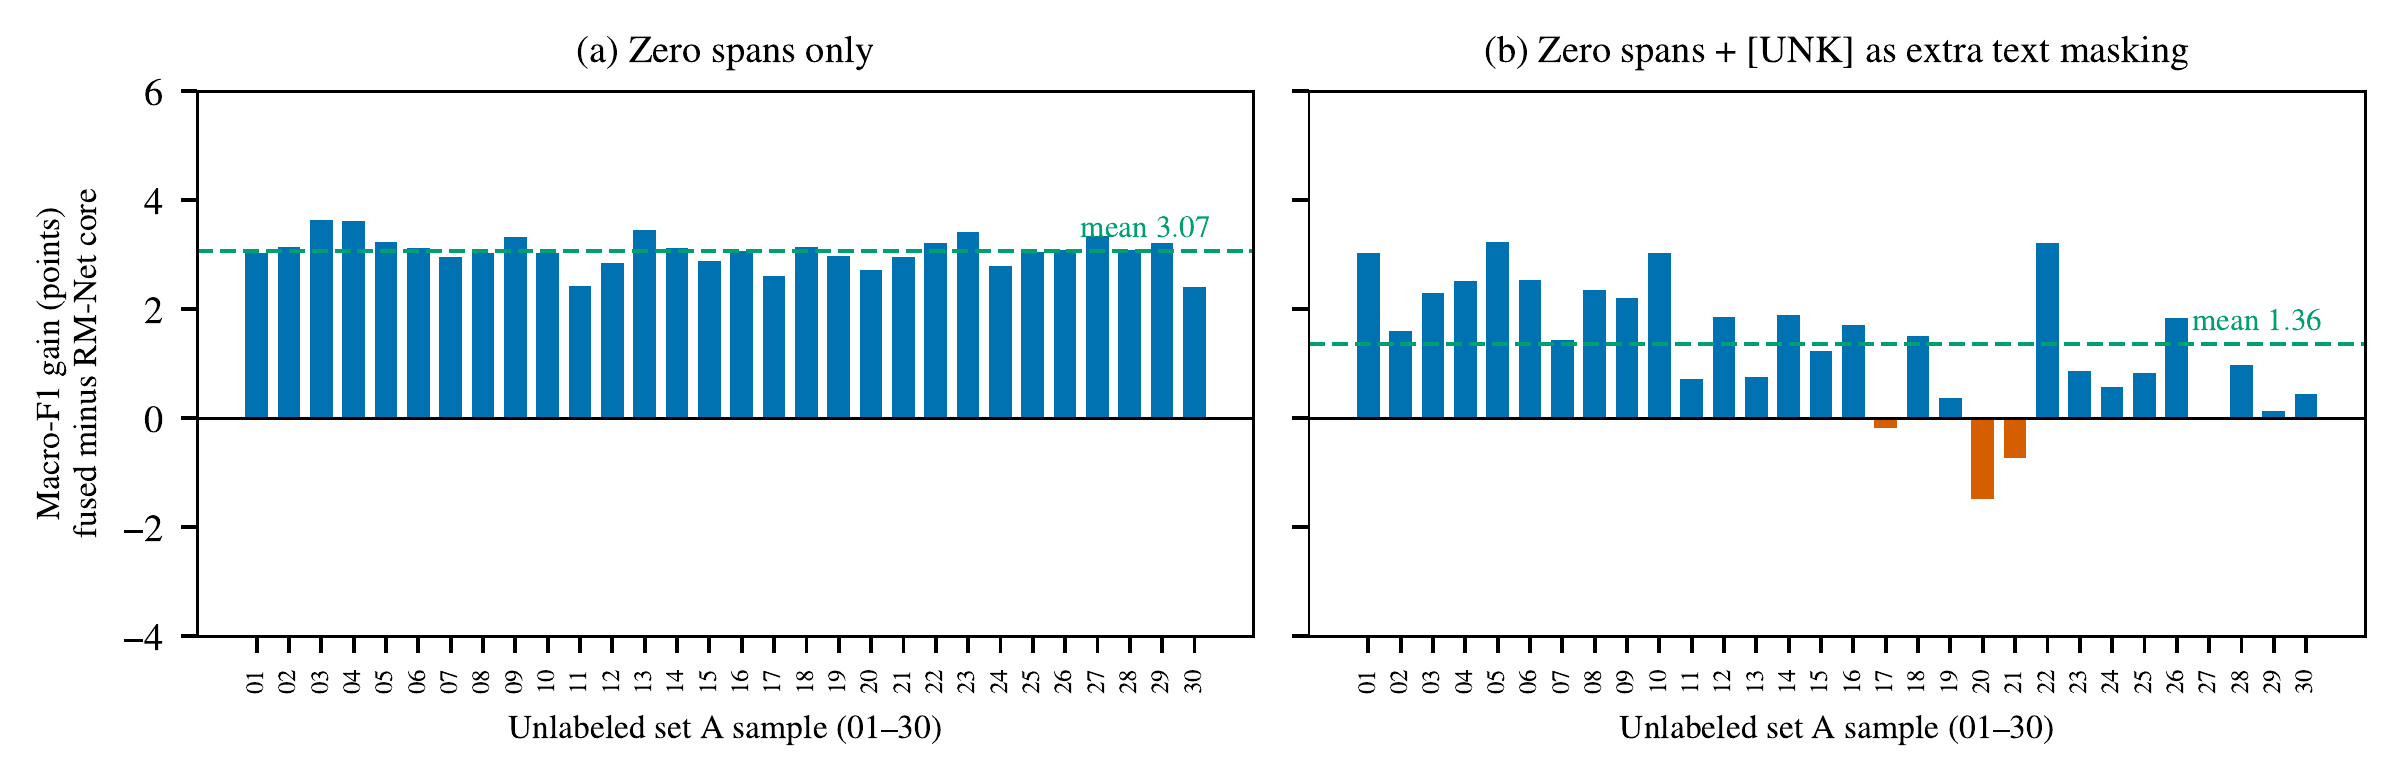
在留出集上回放无标签集合 A 的 30 种零值片段模式,比较融合模型相对 RM-Net 核心的 Macro-F1 增益;右图还遮挡对应的 UNK 位置,虚线表示平均增益。
论文原图 PDF ↗冻结模型完成附件 3 全部 30 条样本的极性与强度预测。专项集缺少真值标签,因此不报告预测准确率。特征遮挡发生在上下文编码后,结论不能直接推广到原始文本完全不可获得的情形。
八子集 Shapley 解释相对空输入的强度变化;内部可加分解显式保留 LoRA 贡献。
固定完整输入时的类别作为解释目标,分别计算模态归因与位置遮挡效应。
728 条验证样本、20 条专项样本;删除 / 保留曲线与 728 组真实删词对照。
RM 门控、内部贡献与 Shapley 含义不同。编码后遮挡仍可能保留上下文;真实删词对照在重新编码后将存活词元映射回原位置。上述解释描述模型依赖,不代表现实情感的因果关系。