实验结果
报告冻结模型的总体性能、同协议候选比较及解释保真度。
总体性能
数据与来源 ↓数据加载中…
混淆矩阵
行:真实类别 · 列:预测类别
真值 y = 0 为中性;预测采用偏置调整后的最终概率最大类,与连续强度分开判定。
均值差异与置信区间
5,000 次原视频簇配对重采样,同一视频的片段及两种视图共同重采样。比较对象是原 RM 辅助头;该差值不表示优于所有文本基线或外部方法。
候选比较
在相同数据划分与输入条件下比较 8 个代表性候选,包含多模态模型、纯文本专家与融合方案。
指标明细与比较条件
候选可包含独立验证选参。“无偏置候选”与最终方案并非只改变一个参数的严格消融。部署使用的融合参数见冻结融合规则 ↗。
解释保真度
对 728 条验证样本实施联合遮挡,并与五次随机排序比较。所选位置具有较大的删除效应;强度保留指标未优于随机对照。
| 目标 / 操作 | 所选 AUC | 随机 AUC | 指标含义 |
|---|
强度使用绝对变化;分类使用原预测类概率的有符号下降。分类保留 AUC 为负表示概率高于原预测,不表示正确率提高。样本配对区间是描述性证据,未校正同源视频簇相关性。
真实删词对照
728 组整词删除并重新编码对照中,有符号效应 Spearman:强度 0.6680、原预测类概率 0.2903。上下文、序列移动和可靠性权重都会变化。
编码前片段删除对照
在验证集先删除缺失片段覆盖的字符、重新编码并将存活词元映射回原位置,融合模型 Macro-F1 从 0.6394 降至 0.6065,同条件 RM-Net 为 0.5813。该检查未用于选参;编码后遮挡会高估文字真正不可获得时的性能。
错误诊断
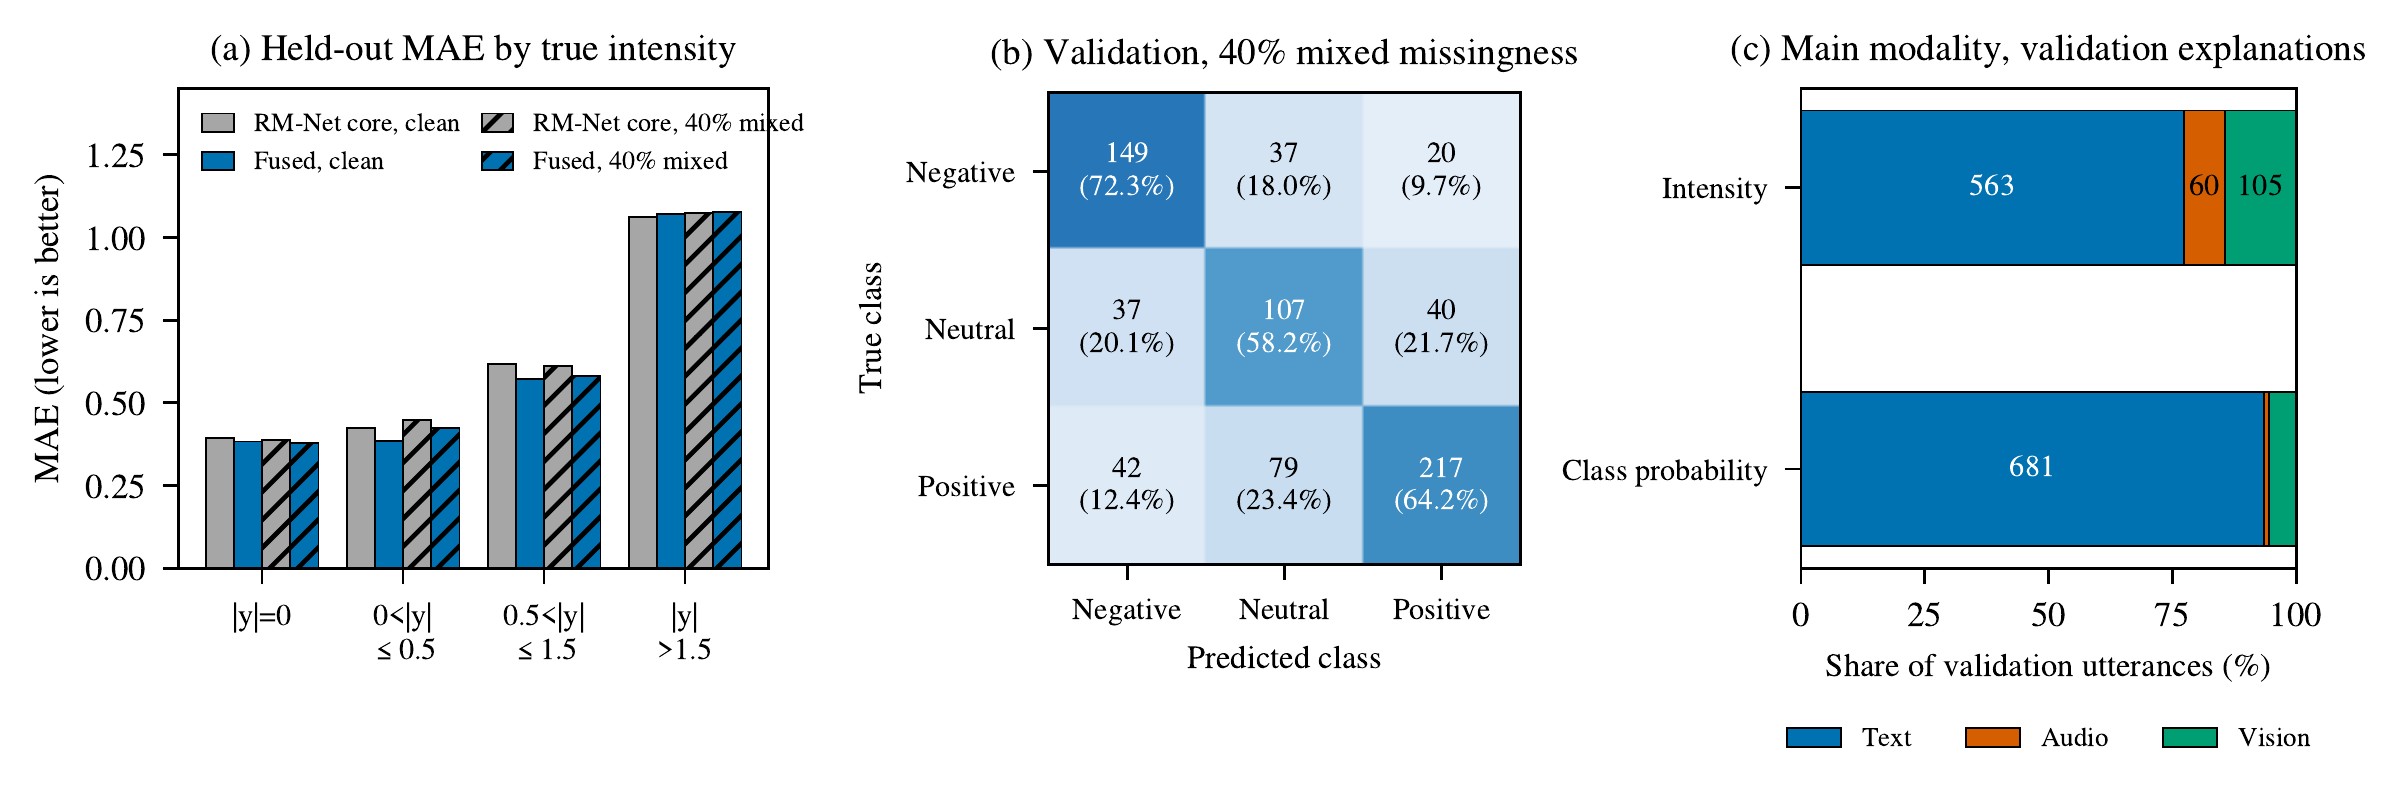
左:727 条留出话语按真实强度分组的 MAE。中:40% 混合缺失下的验证集混淆矩阵。右:728 条验证话语中,两种解释目标的主导模态计数。
论文原图 PDF ↗核心网络缺失扫描
论文附录中的以下扫描评估 RM-Net 核心网络。图 4 的 Macro-F1 使用历史强度阈值,不等同于上方融合模型的最终分类规则。
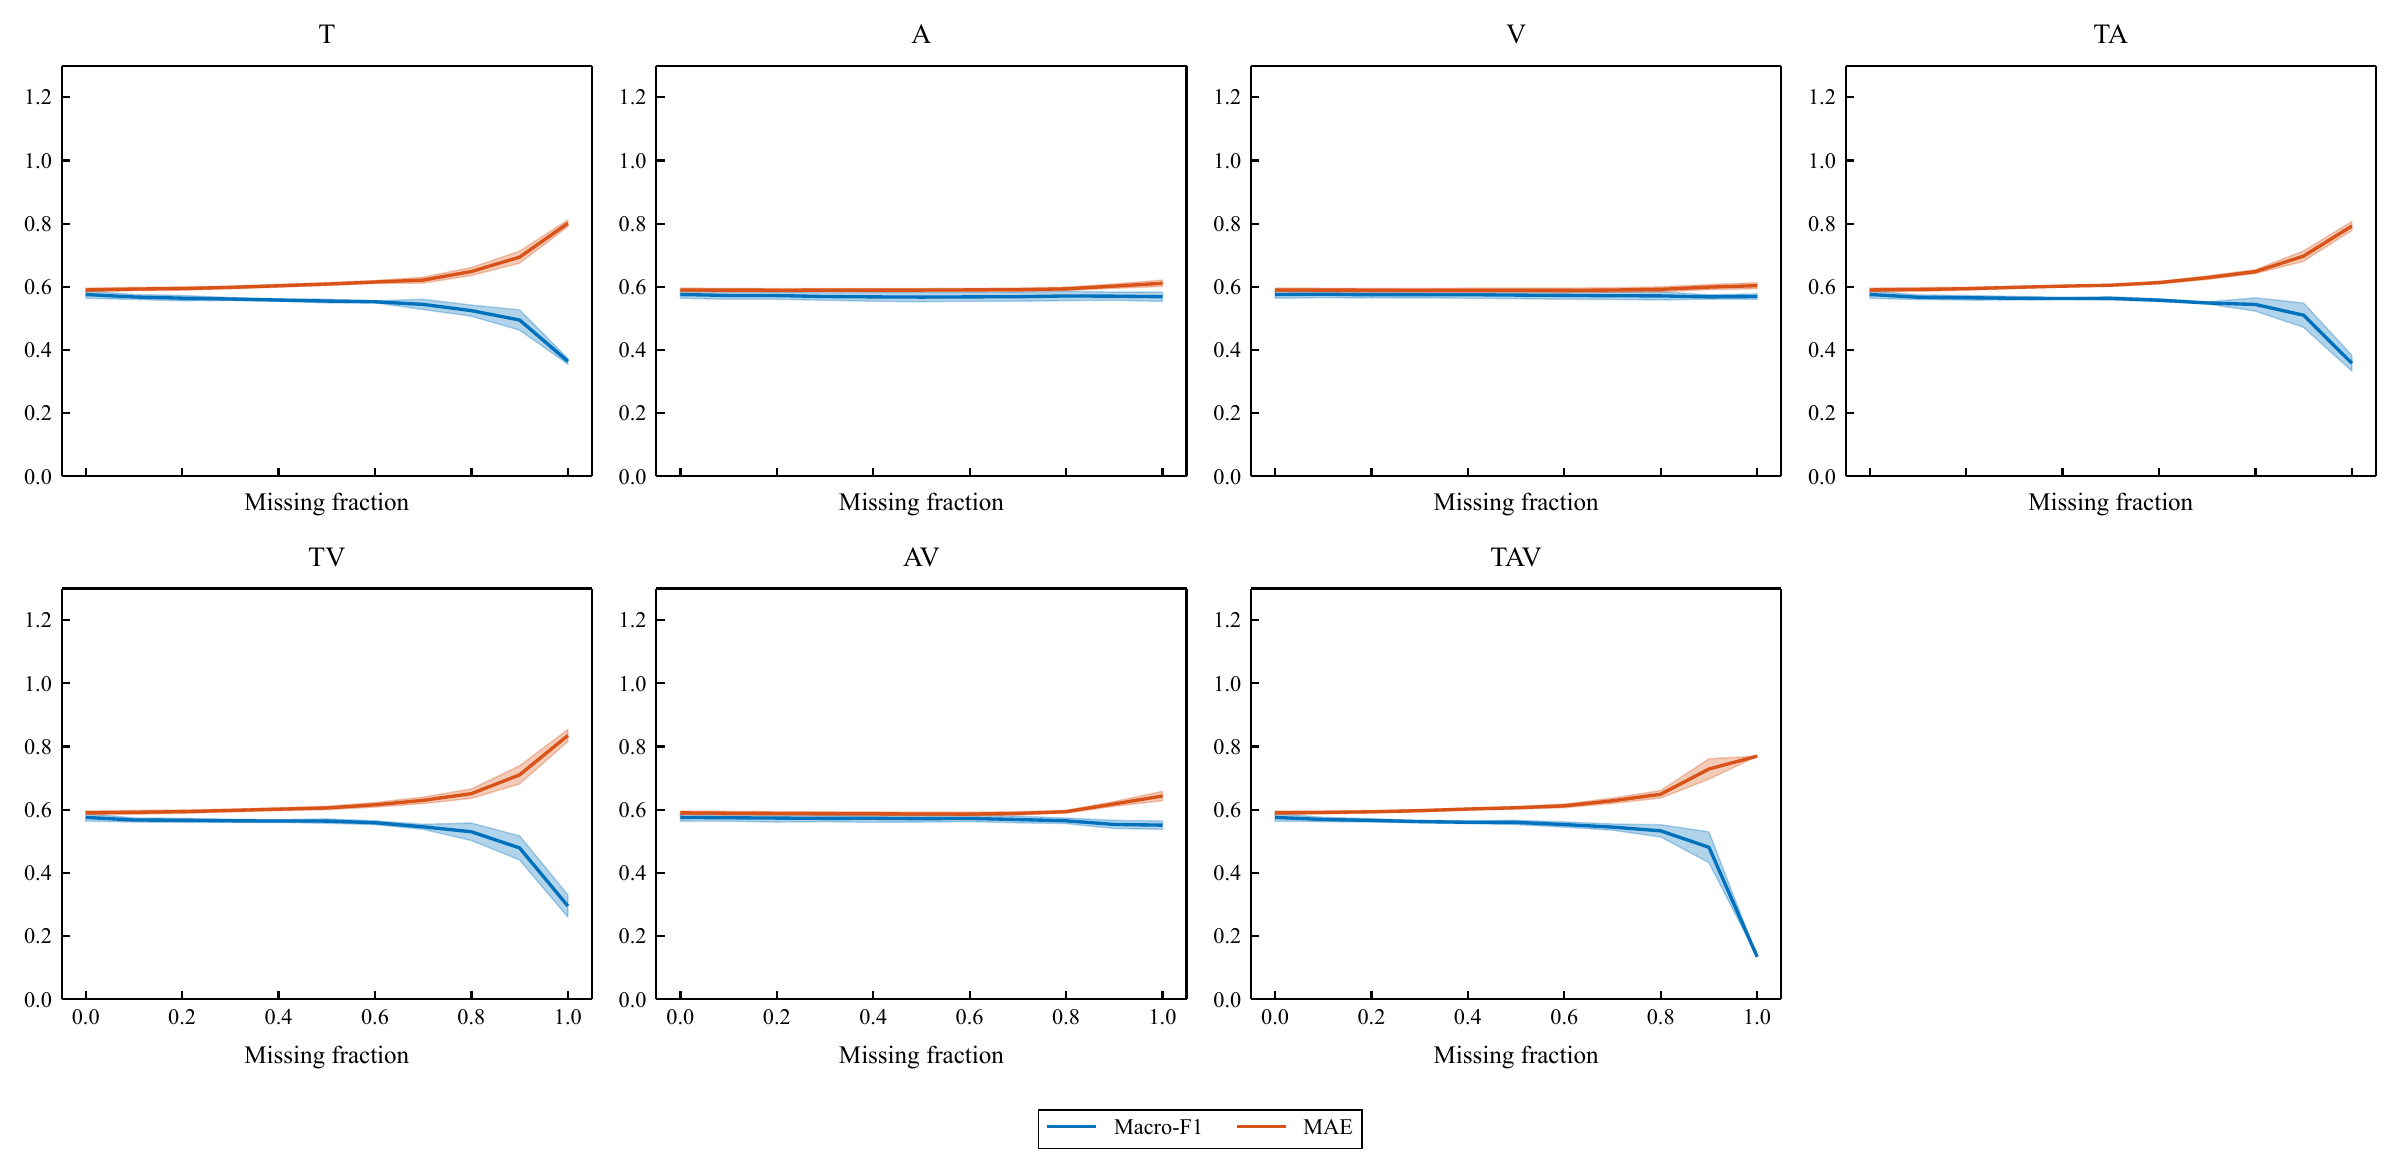
每个子图对应一个受损模态子集,蓝线为 Macro-F1,橙线为 MAE;阴影表示五个训练种子与片段位置上的标准差。
论文原图 PDF ↗查看片段位置、长度与重建扫描
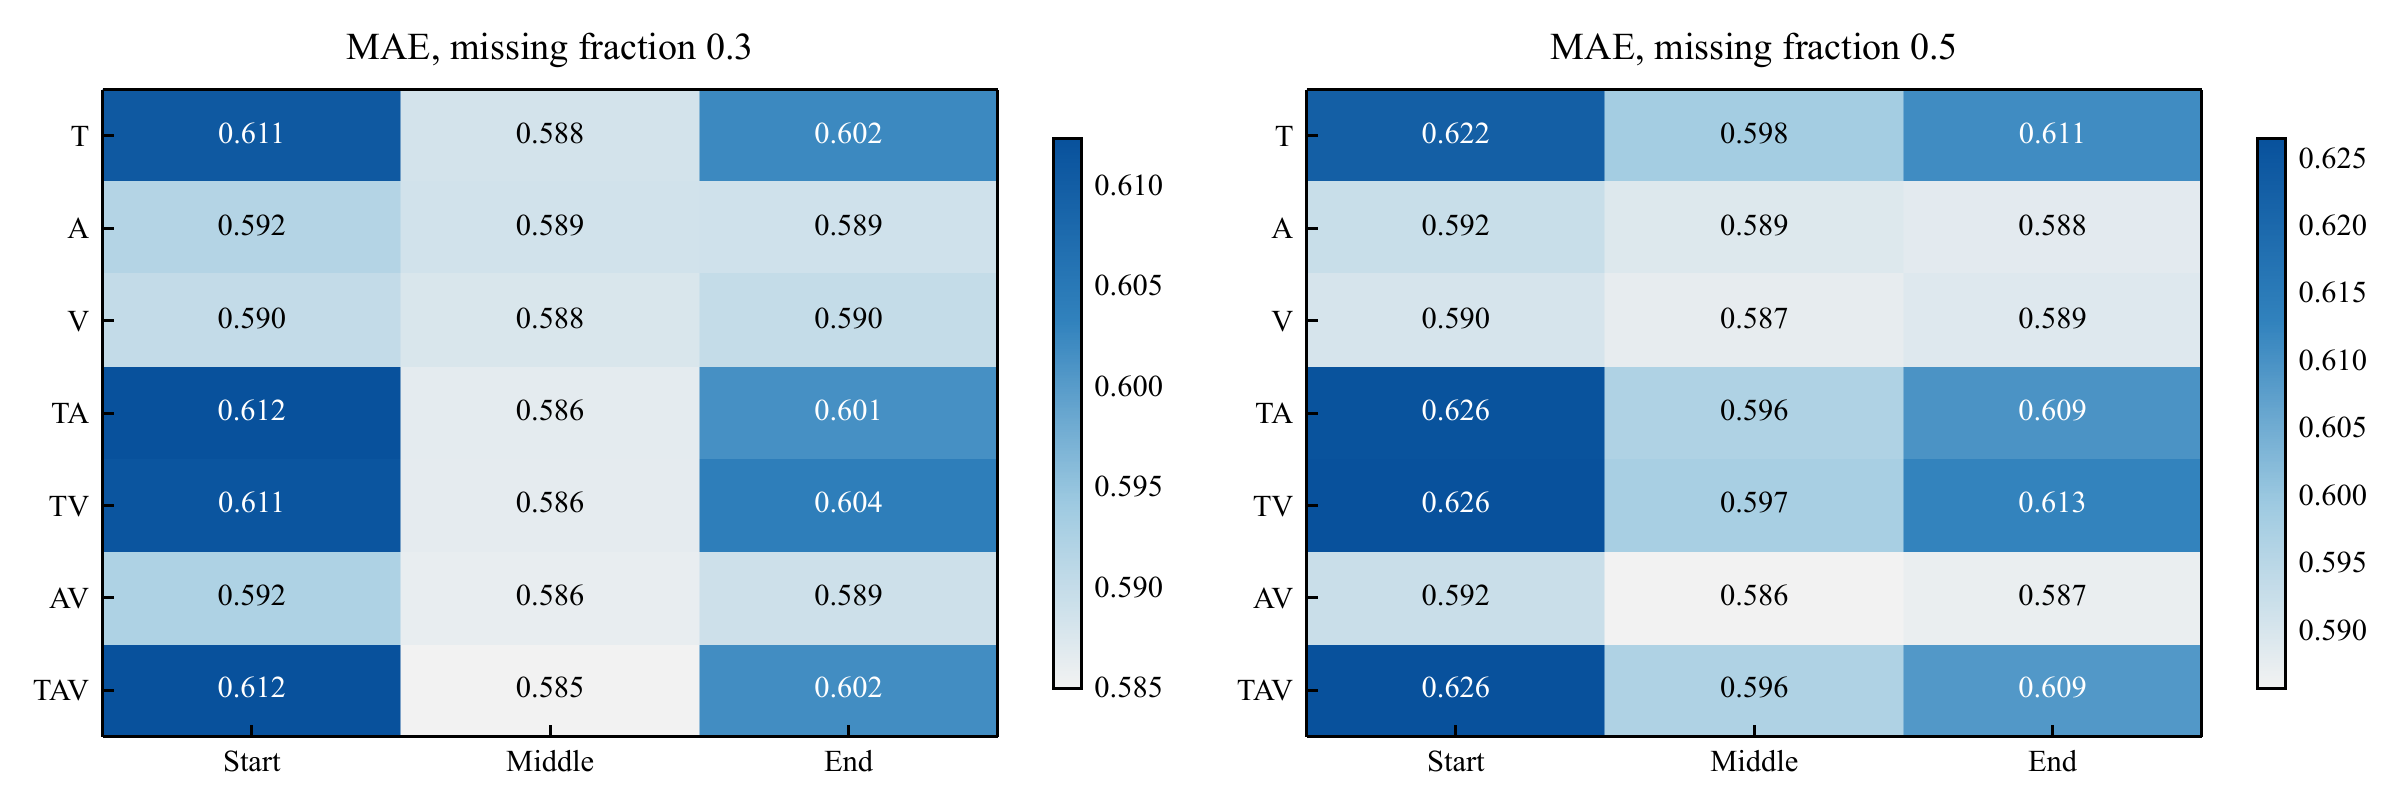
缺失比例为 0.3 和 0.5 时,不同受损模态子集与片段位置上的核心网络 MAE;两幅热图使用不同色标。
论文原图 PDF ↗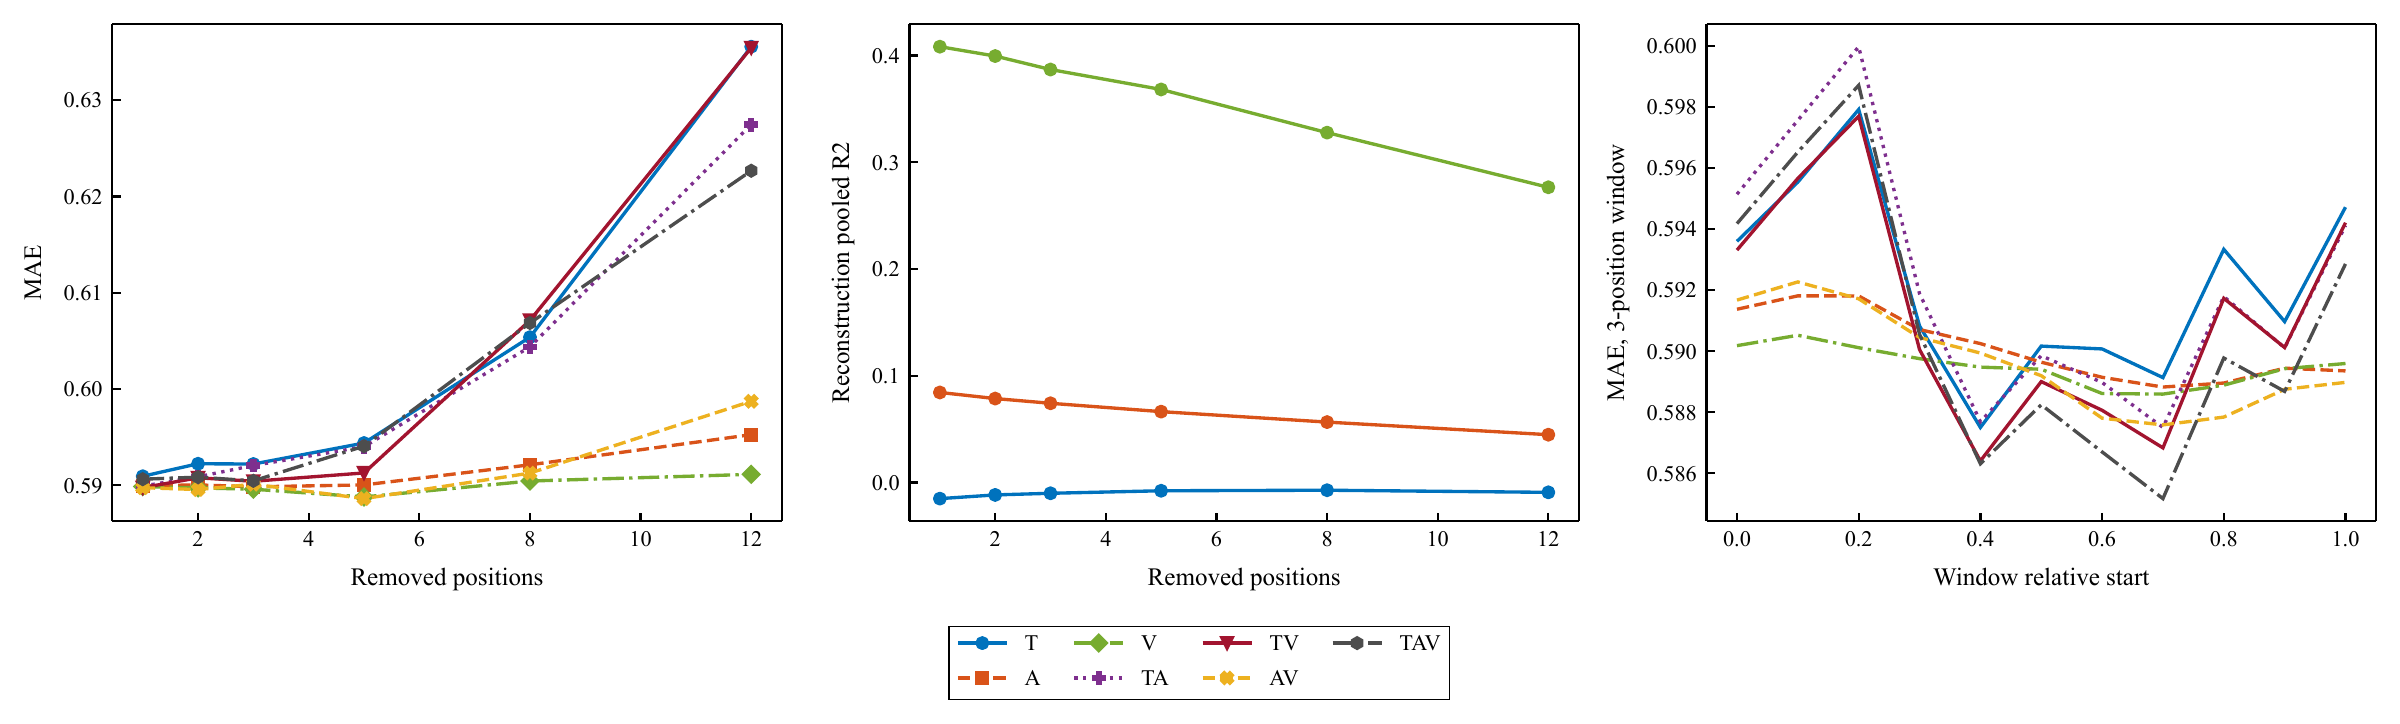
左:随移除位置数变化的 MAE。中:单模态被移除位置上的重建 R²。右:三个位置组成的窗口随相对起点变化时的 MAE。
论文原图 PDF ↗评估设置
- 数据划分
- 训练 3,395 · 验证 728 · 历史留出测试 727,属于提供划分的 CMU-MOSEI 衍生子集,并非官方完整语料。
- 缺失条件
- 40% 位置遮挡,七种模态子集在样本间均衡分配;BERT 在遮挡前编码。
- 冻结依据
- 训练集拟合学习参数;模型结构、检查点和融合规则均在验证集选择。
- 结论范围
- test 曾被查看,不是全新盲测;官方特征实验不能代表手机音视频的实际效果,附件 3 / 4 不报告准确率。